摘要
各种内存的对齐访问以及实验,避免带宽浪费。还对比了 AoS 与 SoA 结构体在 GPU 上的性能表现。
内存管理
固定内存
分配的主机内存默认是可分页的(pageable),操作系统会分配给程序一个很大的虚拟内存,但实际的物理内存会小很多,为了让程序正常运行,操作系统对物理内存以页为单位组织,将数据存储到不同的页中,这些页是不连续的,程序只可以看到虚拟内存地址,而操作系统可能随时更换数据的在物理内存中的页,但是在使用 GPU 时,如果从主机传输到设备上的时候,页被更改了,对于传输数据而言是致命的,所以在传输之前,CUDA 驱动会锁定页面,或者直接分配固定的主机内存,将主机数据复制到固定内存上,再从固定内存传输数据到设备上,如下图左边所示
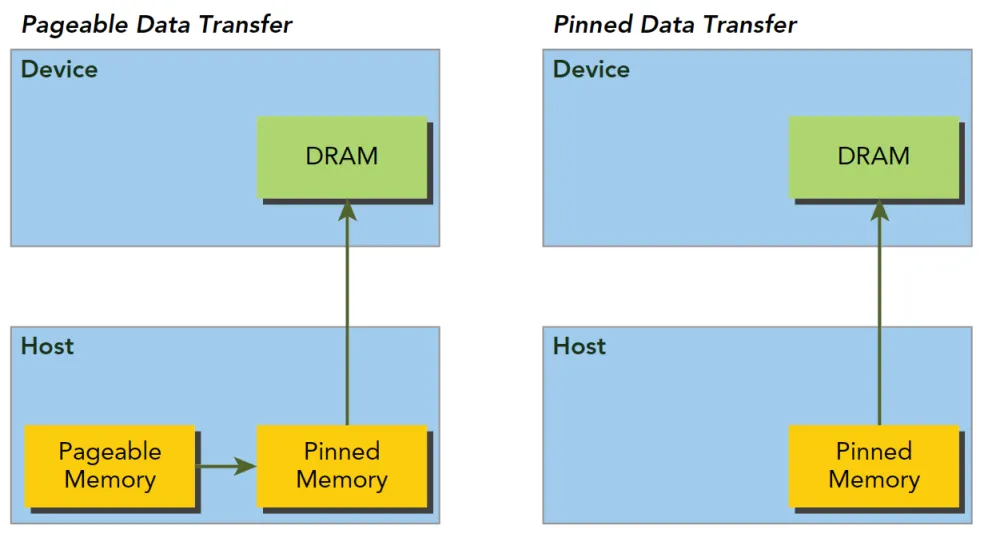
CUDA 运行时可以使用以下指令直接分配固定主机内存,会使传输带宽高很多,如上图右边所示
1
__host__ cudaError_t cudaMallocHost ( void** ptr, size_t size )
ptr: 指针,指向要分配的内存的位置size: 要分配的内存大小
分配后的内存必须使用下面的命令释放
1
__host__ cudaError_t cudaFreeHost ( void* ptr )
我们对第三章中的矩阵相加代码作修改,对比固定内存和分页内存的传输效率,也就是对比cudaMalloc和cudaMallocHost函数所开辟内存空间的传输效率,下面是cudaMalloc版本
1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556575859606162636465666768697071727374757677787980818283848586
#include<cuda.h>
#include<cuda_runtime.h>
#include<stdio.h>
struct Matrix {
   int w;
   int h;
   float *v;
};

__device__ float getValue(Matrix *A, int row, int col) {
   return A->v[row * A->w + col];
}

__device__ void setValue(Matrix *A, int row, int col, float v) {
   A->v[row * A->w + col] = v;
}

__global__ void MatrixAdd(Matrix *A, Matrix *B, Matrix *C) {
        int row = threadIdx.y + blockIdx.y * blockDim.y;
        int col = threadIdx.x + blockIdx.x * blockDim.x;
        setValue(C, row, col, getValue(A, row, col) + getValue(B, row, col));
}

int main() {
    int w = 1 << 11;
    int h = 1 << 11;
    Matrix *A = (Matrix*)malloc(sizeof(Matrix));
    Matrix *B = (Matrix*)malloc(sizeof(Matrix));
    Matrix *C = (Matrix*)malloc(sizeof(Matrix));
    A->h = h;
    A->w = w;
    B->h = h;
    B->w = w;
    C->h = h;
    C->w = w;
    int nBytes = w * h * sizeof(float);
    A->v = (float *)malloc(nBytes);
    B->v = (float *)malloc(nBytes);
    C->v = (float *)malloc(nBytes);

    for (int i = 0; i < w * h; ++i) {
        A->v[i] = 1.0;
        B->v[i] = 2.0;
        C->v[i] = 0.0;
    }

    Matrix *A_d, *B_d, *C_d;

    cudaMalloc((void **)&A_d, sizeof(Matrix));
    cudaMalloc((void **)&B_d, sizeof(Matrix));
    cudaMalloc((void **)&C_d, sizeof(Matrix));

    float *A_d_v = NULL;
    float *B_d_v = NULL;
    float *C_d_v = NULL;

    cudaMalloc((void **)&A_d_v, sizeof(nBytes));
    cudaMalloc((void **)&B_d_v, sizeof(nBytes));
    cudaMalloc((void **)&C_d_v, sizeof(nBytes));

    cudaMemcpy(A_d_v, A->v, sizeof(nBytes), cudaMemcpyHostToDevice);
    cudaMemcpy(B_d_v, B->v, sizeof(nBytes), cudaMemcpyHostToDevice);
    cudaMemcpy(C_d_v, C->v, sizeof(nBytes), cudaMemcpyHostToDevice);

    float *A_d_v_t = A->v;
    float *B_d_v_t = B->v;
    float *C_d_v_t = C->v;

    A->v = A_d_v;
    B->v = B_d_v;
    C->v = C_d_v;

    cudaMemcpy(A_d, A, sizeof(Matrix), cudaMemcpyHostToDevice);
    cudaMemcpy(B_d, B, sizeof(Matrix), cudaMemcpyHostToDevice);
    cudaMemcpy(C_d, C, sizeof(Matrix), cudaMemcpyHostToDevice);

    A->v = A_d_v_t;
    B->v = B_d_v_t;
    C->v = C_d_v_t;

    dim3 blockSize(32, 32);
    dim3 gridSize((w + blockSize.x - 1) / blockSize.x, (h + blockSize.y - 1) / blockSize.y);
    MatrixAdd << < gridSize, blockSize >> >(A_d, B_d, C_d);
    cudaDeviceSynchronize();
    return 0;
}
下面是cudaMallocHost版本
1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556575859606162636465666768697071727374757677787980818283848586
#include<cuda.h>
#include<cuda_runtime.h>
#include<stdio.h>
struct Matrix {
   int w;
   int h;
   float *v;
};

__device__ float getValue(Matrix *A, int row, int col) {
   return A->v[row * A->w + col];
}

__device__ void setValue(Matrix *A, int row, int col, float v) {
   A->v[row * A->w + col] = v;
}

__global__ void MatrixAdd(Matrix *A, Matrix *B, Matrix *C) {
        int row = threadIdx.y + blockIdx.y * blockDim.y;
        int col = threadIdx.x + blockIdx.x * blockDim.x;
        setValue(C, row, col, getValue(A, row, col) + getValue(B, row, col));
}

int main() {
    int w = 1 << 11;
    int h = 1 << 11;
    Matrix *A, *B, *C;
    cudaMallocHost((void **)&A, sizeof(Matrix));
    cudaMallocHost((void **)&B, sizeof(Matrix));
    cudaMallocHost((void **)&C, sizeof(Matrix));
    A->h = h;
    A->w = w;
    B->h = h;
    B->w = w;
    C->h = h;
    C->w = w;
    int nBytes = w * h * sizeof(float);
    cudaMallocHost((void **)&A->v, nBytes);
    cudaMallocHost((void **)&B->v, nBytes);
    cudaMallocHost((void **)&C->v, nBytes);

    for (int i = 0; i < w * h; ++i) {
        A->v[i] = 1.0;
        B->v[i] = 2.0;
    }

    Matrix *A_d, *B_d, *C_d;

    cudaMalloc((void **)&A_d, sizeof(Matrix));
    cudaMalloc((void **)&B_d, sizeof(Matrix));
    cudaMalloc((void **)&C_d, sizeof(Matrix));

    float *A_d_v = NULL;
    float *B_d_v = NULL;
    float *C_d_v = NULL;

    cudaMalloc((void **)&A_d_v, sizeof(nBytes));
    cudaMalloc((void **)&B_d_v, sizeof(nBytes));
    cudaMalloc((void **)&C_d_v, sizeof(nBytes));

    cudaMemcpy(A_d_v, A->v, sizeof(nBytes), cudaMemcpyHostToDevice);
    cudaMemcpy(B_d_v, B->v, sizeof(nBytes), cudaMemcpyHostToDevice);
    cudaMemcpy(C_d_v, C->v, sizeof(nBytes), cudaMemcpyHostToDevice);

    float *A_d_v_t = A->v;
    float *B_d_v_t = B->v;
    float *C_d_v_t = C->v;

    A->v = A_d_v;
    B->v = B_d_v;
    C->v = C_d_v;

    cudaMemcpy(A_d, A, sizeof(Matrix), cudaMemcpyHostToDevice);
    cudaMemcpy(B_d, B, sizeof(Matrix), cudaMemcpyHostToDevice);
    cudaMemcpy(C_d, C, sizeof(Matrix), cudaMemcpyHostToDevice);

    A->v = A_d_v_t;
    B->v = B_d_v_t;
    C->v = C_d_v_t;

    dim3 blockSize(32, 32);
    dim3 gridSize((w + blockSize.x - 1) / blockSize.x, (h + blockSize.y - 1) / blockSize.y);
    MatrixAdd << < gridSize, blockSize >> >(A_d, B_d, C_d);
    cudaDeviceSynchronize();
    return 0;
}
使用nsys nvprof {}.o得到两个版本的数据传输时间
123456789
Time (%) Total Time (ns) Count Avg (ns) Med (ns) Min (ns) Max (ns) StdDev (ns) Operation
-------- --------------- ----- -------- -------- -------- -------- ----------- ------------------
100.0 6817 6 1136.2 992.5 960 1536 243.4 [CUDA memcpy HtoD]
Time (%) Total Time (ns) Count Avg (ns) Med (ns) Min (ns) Max (ns) StdDev (ns) Operation
-------- --------------- ----- -------- -------- -------- -------- ----------- ------------------
100.0 6304 6 1050.7 992.0 928 1344 153.4 [CUDA memcpy HtoD]
可以看到使用cudaMallocHost函数相比cudaMalloc,因其固定内存的特性,传输效率高了一些
上面程序中用cudaMalloc将结构体从主机传输到设备的方法十分繁琐且已经过时了,在这里只作测试,建议使用第三章中提到的cudaMallocManaged函数,后续会详细介绍该函数
零拷贝内存
在 GPU 编程中,主机变量和设备变量之间一般不能直接相互访问,但主机变量和设备变量都可以访问零拷贝内存。GPU线程可以直接访问主机里的零拷贝内存,当有以下几种情况时核函数会使用零拷贝内存
- 当设备内存不足时
- 避免主机和设备之间的显式内存传输
- 为了提高PCIe传输率
当使用零拷贝内存时要同步设备和主机间的内存访问,避免内存竞争。零拷贝内存是固定内存,不可分页。使用以下函数可以创建零拷贝内存
1
__host__ cudaError_t cudaHostAlloc ( void** pHost, size_t size, unsigned int flags )
-
pHost: 指向将被分配的内存地址
-
size: 要分配的内存块的大小
-
flags: 用于控制函数行为,可选如下
-
cudaHostAllocDefault: 默认,和cudaMallocHost一致,使用系统的默认内存类型分配内存,
-
cudaHostAllocPortable: 分配固定内存,可以被所有 CUDA 上下文使用
-
cudaHostAllocMapped: 分配零拷贝内存,将内存分配映射到设备的地址空间,必须使用以下函数得到指向主机上零拷贝内存的设备指针 pDevice,设备才能访问零拷贝内存
1
cudaError_t cudaHostGetDevicePointer(void ** pDevice,void * pHost,unsigned flags);
pDevice: 访问主机零拷贝内存的设备指针pHost: 同上pHostflags: 此处必须置0,后续介绍原因
-
cudaHostAllocWriteCombined: 将内存分配为写组合(Write-combined memory),可以在某些系统配置上更快地通过 PCIe 传输,提高设备写入内存的性能
主机上固定内存的释放
1
__host__ cudaError_t cudaFreeHost ( void* ptr )
下面的程序计算了向量乘法,对比了cudaMallocHost和cudaHostAlloc的传输效率
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990
#include <cuda_runtime.h>
#include <stdio.h>
__global__ void ArraySum(float*a,float*b,float*res) {
int i=blockIdx.x*blockDim.x+threadIdx.x;
res[i]=a[i]+b[i];
}
int main(int argc,char **argv) {
int dev = 0;
cudaSetDevice(dev);
int nElem=1<<20;
int nBytes=sizeof(float)*nElem;
float *A_hp,*B_hp;
float *A_dp,*B_dp,*C_dp;
A_hp = (float *)malloc(nBytes);
B_hp = (float *)malloc(nBytes);
memset(A_hp,1,nBytes);
memset(B_hp,2,nBytes);
cudaMalloc((float**)&A_dp,nBytes);
cudaMalloc((float**)&B_dp,nBytes);
cudaMalloc((float**)&C_dp,nBytes);
cudaMemcpy(A_dp,A_hp,nBytes,cudaMemcpyHostToDevice);
cudaMemcpy(B_dp,B_hp,nBytes,cudaMemcpyHostToDevice);
dim3 block(1024);
dim3 grid(nElem/block.x);
float *A_hm, *B_hm, *C_hm;
float *A_dm, *B_dm, *C_dm;
cudaHostAlloc((float**)&A_hm, nBytes, cudaHostAllocMapped);
cudaHostAlloc((float**)&B_hm, nBytes, cudaHostAllocMapped);
cudaHostAlloc((float**)&C_hm, nBytes, cudaHostAllocMapped);
for(int i=0; i<nElem; i++) {
A_hm[i]=1.0;
B_hm[i]=2.0;
C_hm[i]=0.0;
}
cudaHostGetDevicePointer((void**)&A_dm, (void*)A_hm, 0);
cudaHostGetDevicePointer((void**)&B_dm, (void*)B_hm, 0);
cudaHostGetDevicePointer((void**)&C_dm, (void*)C_hm, 0);
cudaEvent_t start, stop;
cudaEventCreate(&start);
cudaEventCreate(&stop);
cudaEventRecord(start, 0);
ArraySum<<<grid, block>>>(A_dp, B_dp, C_dp);
cudaEventRecord(stop, 0);
cudaEventSynchronize(stop);
float elapsedTime=0;
cudaEventElapsedTime(&elapsedTime, start, stop);
printf("cudaMallocHost: %f ms\n", elapsedTime);
cudaEventRecord(start, 0);
ArraySum<<<grid, block>>>(A_dm, B_dm, C_dm);
cudaEventRecord(stop, 0);
cudaEventSynchronize(stop);
elapsedTime=0;
cudaEventElapsedTime(&elapsedTime, start, stop);
printf("cudaHostAlloc: %f ms\n", elapsedTime);
cudaEventDestroy(start);
cudaEventDestroy(stop);
free(A_hp);
free(B_hp);
cudaFreeHost(A_hm);
cudaFreeHost(B_hm);
cudaFreeHost(C_hm);
cudaFree(A_dp);
cudaFree(B_dp);
cudaFree(C_dp);
cudaFree(A_dm);
cudaFree(B_dm);
cudaFree(C_dm);
return 0;
}
cudaMallocHost: 0.050720 ms
cudaHostAlloc: 1.258496 ms
可以看到零拷贝内存的内核函数执行效率会大大降低,因为其数据的传输是在执行内核函数时,这种执行方式不适合离散架构,如我们平时用的通过 PCIe 总线传输数据的独显 + CPU 架构,而非常适合在 Nvidia 集成架构的设备上使用,也就是共享物理内存的架构
统一虚拟寻址
统一虚拟寻址(UVA)是 Nvidia 在计算能力 2.0 之后的设备支持的特殊寻址方式,设备内存和主机内存被映射到统一虚拟内存地址中,共享一个虚拟地址空间,如下图所示
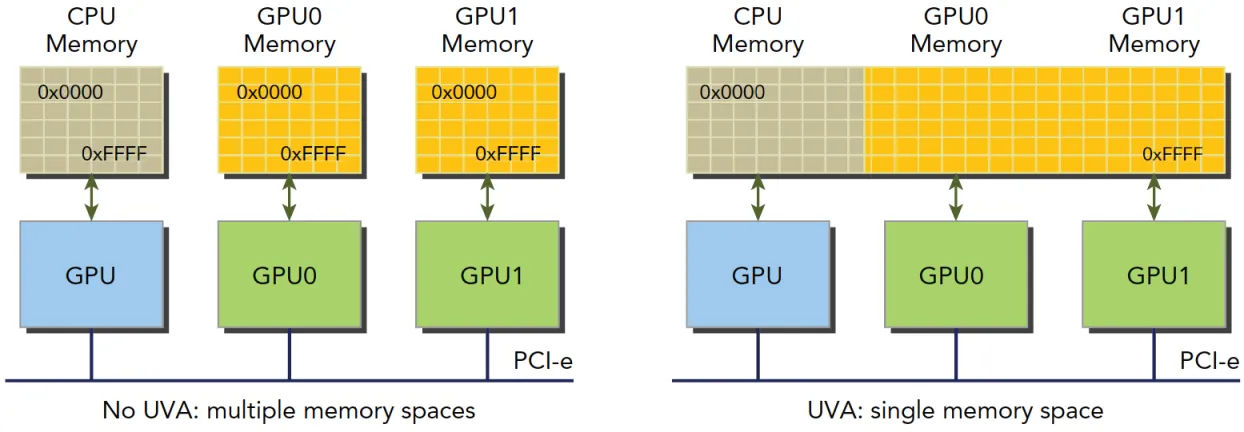
在 UVA 出来之前,代码中的指针变量需要区分指向主机内存还是设备内存,通过UVA,可以通过cudaHostAlloc 函数分配固定主机内存,指针指向相同的主机和设备地址,可以直接将指针传递给核函数,相当于省略了零拷贝内存的cudaHostGetDevicePointer步骤
删除前面的零拷贝内存代码中cudaHostGetDevicePointer函数和设备指针部分,如下代码就使用了 UVA 的寻址方式
123456789101112131415161718192021222324252627282930
int main(int argc,char **argv) {
    int dev = 0;
    cudaSetDevice(dev);

    int nElem=1<<20;
    int nBytes=sizeof(float)*nElem;

    dim3 block(1024);
    dim3 grid(nElem/block.x);

    float *A_h, *B_h, *C_h;

    cudaHostAlloc((float**)&A_h, nBytes, cudaHostAllocMapped);
    cudaHostAlloc((float**)&B_h, nBytes, cudaHostAllocMapped);
    cudaHostAlloc((float**)&C_h, nBytes, cudaHostAllocMapped);

    for(int i=0; i<nElem; i++) {
        A_h[i]=1.0;
        B_h[i]=2.0;
        C_h[i]=0.0;
    }

    ArraySum<<<grid, block>>>(A_h, B_h, C_h);

    cudaFreeHost(A_h);
    cudaFreeHost(B_h);
    cudaFreeHost(C_h);

    return 0;
}
统一内存寻址
在 CUDA 6.0 中,又引入了统一内存寻址的特性,用于简化内存管理。统一内存中创建了一个托管内存池,内存池中已分配的空间可以用相同的指针在 CPU 和 GPU 上进行访问。底层系统在统一的内存空间中自动的进行设备和主机间的传输
统一内存寻址依赖于前面提到的 UVA,不同之处在于
- 统一内存寻址提供了一个“单指针到数据”的编程模型,通过底层系统进行统一内存管理,被称为托管内存,自己分配的内存称为未托管内存,两种类型的内存可以同时传递给核函数
- UVA 的分配是先在主机上完成,在核函数运行前才传输数据给设备
托管内存可以被静态分配或动态分配,在定义设备变量时添加 __managed__ 关键字修饰静态托管内存变量,如下代码所示,静态声明的托管内存作用域是文件,该变量可以在主机或设备代码中直接引用
第三章使用过的cudaMallocManaged函数就是动态分配托管内存变量
1
__host__ cudaError_t cudaMallocManaged ( void** devPtr, size_t size, unsigned int flags = cudaMemAttachGlobal )
devPtr: 开辟数据的首指针size: 开辟的设备内存空间长度flags: 默认为cudaMemAttachGlobal
cudaMemAttachGlobal: 开辟的内存可以被任何设备上的任何流访问,流的概念将在下一章节介绍cudaMemAttachHost: 开辟的内存不能被任何设备上的任何流访问
使用cudaMallocManaged函数动态声明数组,分配托管内存变量
123456789101112131415161718192021222324252627282930
int main(int argc,char **argv) {
    int dev = 0;
    cudaSetDevice(dev);

    int nElem=1<<20;
    int nBytes=sizeof(float)*nElem;

    dim3 block(1024);
    dim3 grid(nElem/block.x);

    float *A, *B, *C;

    cudaMallocManaged((float**)&A, nBytes);
    cudaMallocManaged((float**)&B, nBytes);
    cudaMallocManaged((float**)&C, nBytes);

    for(int i=0; i<nElem; i++) {
        A[i]=1.0;
        B[i]=2.0;
        C[i]=0.0;
    }

    ArraySum<<<grid, block>>>(A, B, C);

    cudaFree(A);
    cudaFree(B);
    cudaFree(C);

    return 0;
}
内存访问模式
多数 GPU 程序容易受到内存带宽的限制,所以最大程度的利用全局内存带宽,提高全局加载效率,是调控内核函数性能的基本条件。如果不能正确管理全局内存,那么优化方案可能也收效甚微
在 CUDA 执行模型中得知 CUDA 执行的基本单位是线程束,所以内存访问和数据存储也是以线程束为基本单位发布和执行的,在线程束的 32 个线程中,每个线程都会提出一个包含请求地址的单一内存访问请求,根据线程束中内存地址的分布,内存访问会被分成不同的模式,下面将介绍这些不同的内存访问模式,并学习实现最佳的全局内存访问
对齐与合并访问
全局内存(DRAM)是一个逻辑内存空间,可以通过核函数访问它,所有的程序数据都是储在物理设备内存上,也就是 DRAM 设备上,核函数的内存请求通常是在 DRAM 设备和片上内存间上以 32 字节或 128 字节粒度的内存事务来实现,内存事务就是从内核函数发起请求,到硬件响应返回数据过程
所有对全局内存的访问都会通过二级缓存,也有许多访问会通过一级缓存,这取决于访问类型和 GPU 架构
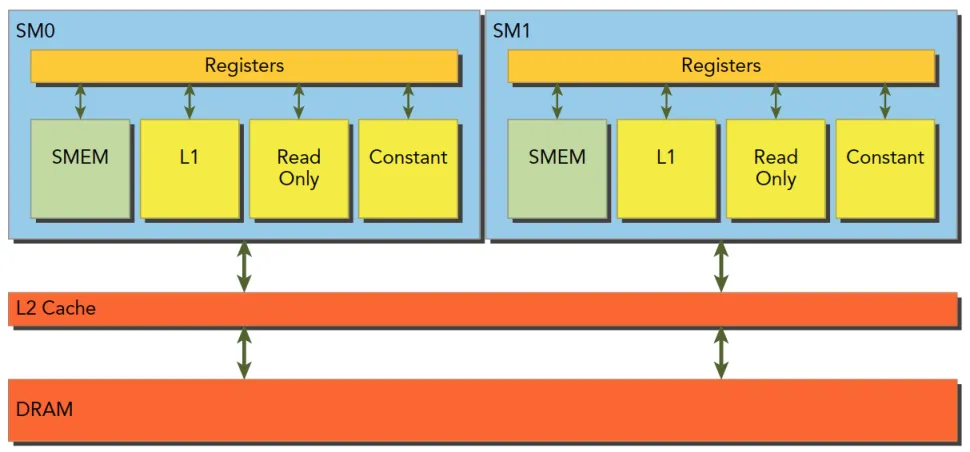
称 L1 为一级缓存,L2 为二级缓存,如下图所示,每个 SM 都有自己 L1,但是 L2 是所有 SM 公用的,核函数运行时需要从 DRAM 中读取数据,读取时如果使用 L1 则从 DRAM 上一次加载的数据是 128 字节,如果不使用 L1 则从 DRAM 上一次加载的数据是 32 字节
一行一级缓存是 128 字节,映射到设备内存中一个 128 字节的对齐段,如果线程束中的每个线程请求一个 4 字节的值,那么每次请求都会获取 4 x 32 = 128 字节的数据,这恰好与缓存行和设备内存段的大小相契合,因此我们要注意设备内存访问的:
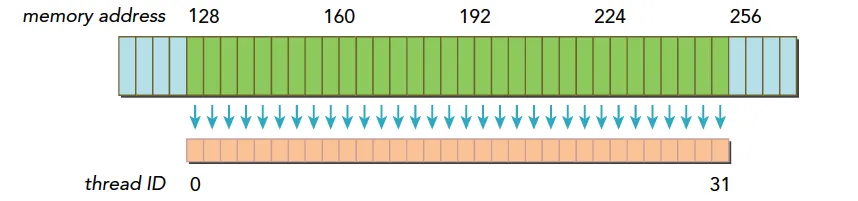
当设备内存事务的第一个地址是用于事务服务的缓存粒度的偶数倍数时(32或128字节),称为对齐内存访问,当一个线程束内的线程访问的内存都在一个内存块里的时候,就会出现合并访问。对齐与合并访问的情况如下图所示,只需要 128 字节的内存事务从设备内存中读取数据
但如果一个内存事务加载的数据分布在不一个对齐的地址段上,就会有以下两种情况
- 内存地址连续,但不在一个对齐的段上,如请求访问的数据分布在内存地址 1-128,那么 0-127 和 128-255 这两段数据要传递两次到 SM
- 内存地址不连续,也不在一个对齐的段上,如请求访问的数据分布在内存地址 0-63 和 128-191 上,那么这两段数据也要传递两次
上述两种情况会使内存事务获取的大部分字节不能使用,造成带宽的浪费,如下图所示
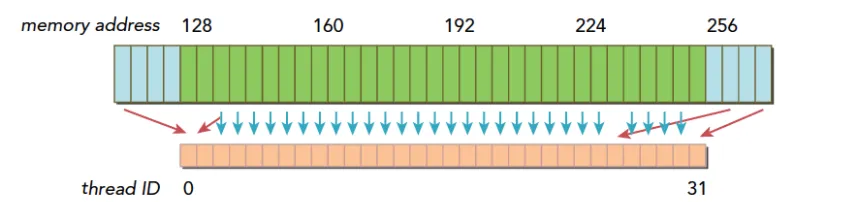
我们需要优化内存事务的效率,提高吞吐量
全局内存读取
SM 中的数据根据不同的设备和类型以 3 种不同的路径进行传输
默认路径是 L1 和 L2,需要使用常量和只读缓存的需要在代码中显式声明。但是提高性能还是要取决于访问模式,全局加载操作是否通过 L1 可以通过编译选项来控制,在计算能力为 2.X 和 3.5 以上的 GPU 中,可以通过以下编译器标识符禁用 L1
通过以下编译器标识符启用 L1
当 SM 有全局加载请求会首先尝试通过 L1,如果 L1 被禁用,请求转向 L2,如果 L2 缺失,则由 DRAM 完成请求,在这种情况下,内存加载请求由 128 字节的设备内存事务实现
Kepler K10, K20, K20X GPU 中,L1 不用来缓存全局内存访问,只用来存储寄存器溢出的本地数据
缓存加载
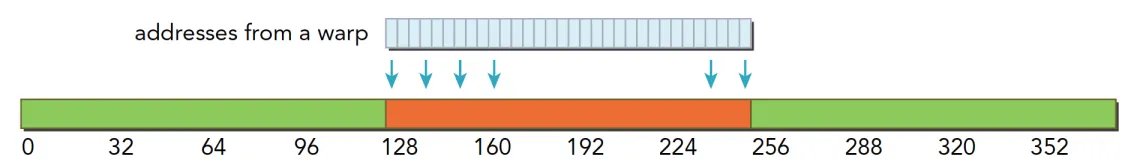
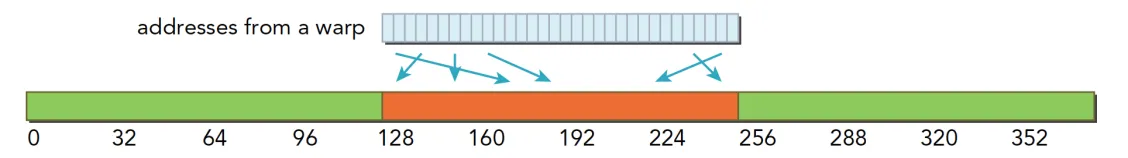
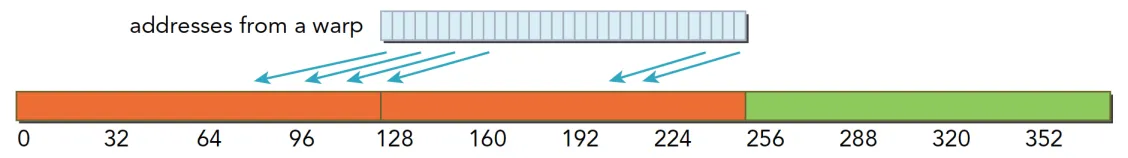
缓存加载是指经过 L1,在粒度为 128 字节的 L1 上由设备内存事务进行传输。缓存加载可以分为对齐/非对齐但合并/非合并
下图所示为对齐合并的情况,利用率为 100%
对齐但不连续的情况,利用率为 100%
非对齐但连续的情况,因为线程束请求的 32 个连续的 4 字节元素在两个 128 字节段内,所以利用率为 50%
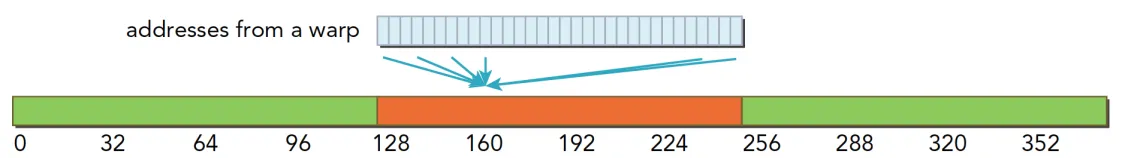
线程束中所有线程请求同一个地址的情况,利用率为 4/128 = 3.125%
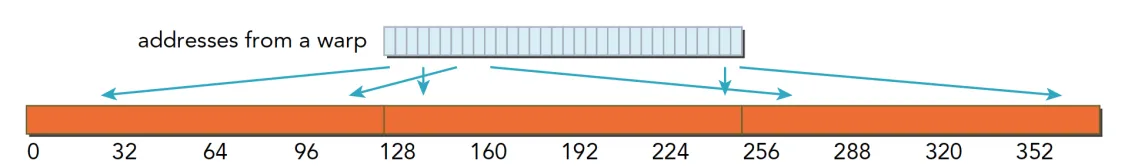
最坏的情况,每个线程束内的线程请求的都是不同的缓存行内,比较坏的情况就是所有数据分布在 N 个缓存行上,其中 1≤N≤32,请求 32 个 4 字节的数据就需要 N 个事务来完成,利用率为 1/N
CPU 和 GPU 的 L1 有明显的差异,CPU 的 L1 优化了时间和空间局部性,GPU 的 L1 是专为空间局部性设计的,频繁访问 L1 中内存位置不会增加数据留存缓存中的概率
没有缓存的加载
没有缓存的加载是指不经过 L1,只经过 L2,在粒度为 32 字节的 L2 上由设备内存事务进行传输,更细的粒度代表更高的利用率
下图所示为对齐合并的情况,128 字节请求的地址占用了 4 个内存段,利用率为 100%
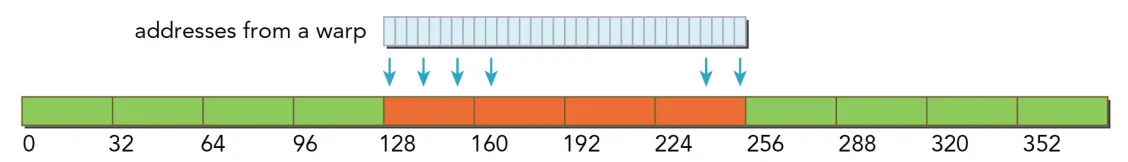
对齐但不连续的情况,利用率为 100%
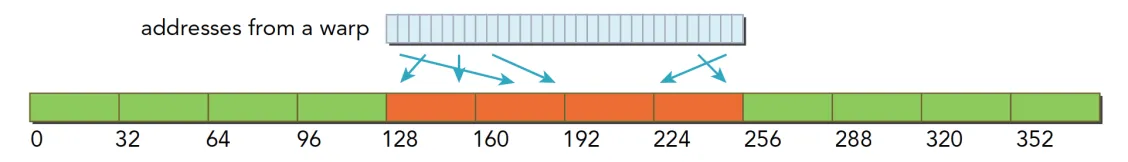
非对齐但连续的情况,因为线程束请求的 32 个连续的 4 字节元素但加载没有对齐到 128 个字节的边界,请求的地址最多落在 5 个内存段内,所以利用率为 4/5 = 80%
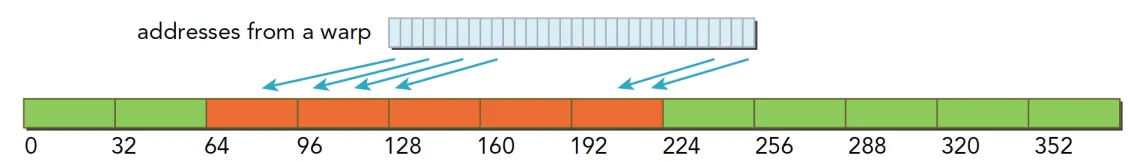
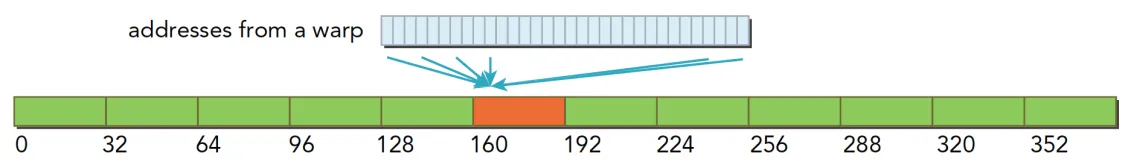
线程束中所有线程请求同一个地址的情况,利用率为 4/32 = 12.5%
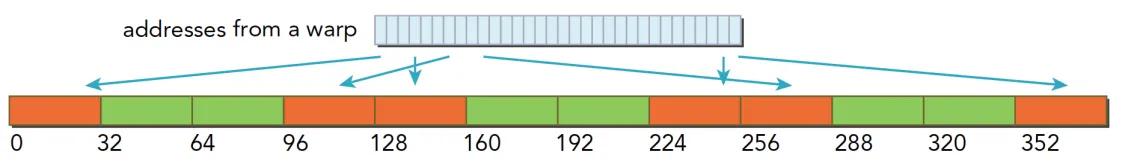
最坏的情况,每个线程束内的线程请求的都是不同的缓存行内,由于请求的 128 个字节最多落在 N 个 32 字节的内存段内而不是 N 个 128 字节的缓存行内,所以相比缓存加载,即使是最坏的情况也有所改善
非对齐读取示例
对之前的ArraySum核函数代码执行加上偏移量
12345678910111213141516171819202122232425262728293031323334353637383940414243444546474849505152535455
#include <cuda_runtime.h>
#include <stdio.h>
__global__ void ArraySum(float*a, float*b, float*c, int offset, int n) {
    int i = blockIdx.x*blockDim.x+threadIdx.x;
    int k = i+offset;
    if(k < n)
        c[i] = a[k]+b[k];
}

int main(int argc, char **argv) {
    int dev = 0;
    cudaSetDevice(dev);

    int nElem=1<<20;
    int nBytes=sizeof(float)*nElem;

    int offset=0;
    if(argc>=2)
        offset = atoi(argv[1]);

    dim3 block(1024);
    dim3 grid(nElem/block.x);

    float *A, *B, *C;

    cudaMallocManaged((float**)&A, nBytes);
    cudaMallocManaged((float**)&B, nBytes);
    cudaMallocManaged((float**)&C, nBytes);

    for(int i=0; i<nElem; i++) {
        A[i]=1.0;
        B[i]=2.0;
        C[i]=0.0;
    }

    cudaEvent_t start, stop;
    cudaEventCreate(&start);
    cudaEventCreate(&stop);
    cudaEventRecord(start, 0);

    ArraySum<<<grid, block>>>(A, B, C, offset, nElem);
    cudaDeviceSynchronize();

    cudaEventRecord(stop, 0);
    cudaEventSynchronize(stop);
    float elapsedTime=0;
    cudaEventElapsedTime(&elapsedTime, start, stop);
    printf("<<<grid, block>>>: <<<%d,%d>>> Time elapsed: %f ms offset: %d \n", grid.x, block.x, elapsedTime, offset);

    cudaFree(A);
    cudaFree(B);
    cudaFree(C);

    return 0;
}
我们这里使用 Nsight Compute 交互式内核分析工具,一般安装完 CUDA Toolkit 会在安装目录中,我们只需要添加环境变量即可,如没有请在官网下载,详细的使用方法请查看官网文档
注意类似 Docker 之类的虚拟机用户(如租赁的 GPU)没有权限使用 Nsight Compute 访问 GPU,需要在物理机上以管理员权限使用
编译命令
12
nvcc -Xptxas -dlcm=cg {}.cu -o {}_cg.out
nvcc -Xptxas -dlcm=ca {}.cu -o {}_ca.out
测试不同的偏移量获得的全局加载效率
全局加载效率 = 请求的全局内存加载吞吐量 / 所需的全局内存加载吞吐量
启用 L1
123
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_ca.out 0
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_ca.out 11
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_ca.out 128
- offset=0 : gld_efficiency 100%
- offset=11 : gld_efficiency 40%
- offset=128 : gld_efficiency 100%
可以看出偏移量会直接导致性能损失
禁用 L1
123
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_cg.out 0
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_cg.out 11
ncu --metrics smsp__sass_average_data_bytes_per_sector_mem_global_op_ld.pct ./{}_cg.out 128
- offset=0 : gld_efficiency 100%
- offset=11 : gld_efficiency 80%
- offset=128 : gld_efficiency 100%
禁用 L1 后同样偏移 11 的全局加载效率提高了不多,也验证了上面提到的更细的词粒度会带来更好的性能
只读缓存
只读缓存最初是留给纹理内存加载用的,在 计算能力 3.5 以上的设备,只读缓存也支持使用全局内存加载代替一级缓存
只读缓存粒度为 32 字节,对于分散读取,细粒度优于一级缓存,有两种方法让内存从只读缓存读取
考虑如下代码
1234
__global__ void ArraySum(float*a,float*b,float*res) {
    int i=blockIdx.x*blockDim.x+threadIdx.x;
    res[i]=a[i]+b[i];
}
使用__ldg通过只读缓存对数组进行读取访问
1234
__global__ void ArraySum(float*a,float*b,float*res) {
    int i=blockIdx.x*blockDim.x+threadIdx.x;
    res[i]= __ldg(&a[i]) + __ldg(&b[i]);
}
也可以常量__restrict__修饰符应用到指针上,nvcc 将自动通过只读缓存指导无别名指针的加载
1234
__global__ void ArraySum(const float* __restrict__ a, const float* __restrict__ b, float* __restrict__ res) {
    int i=blockIdx.x*blockDim.x+threadIdx.x;
    res[i]=a[i]+b[i];
}
全局内存写入
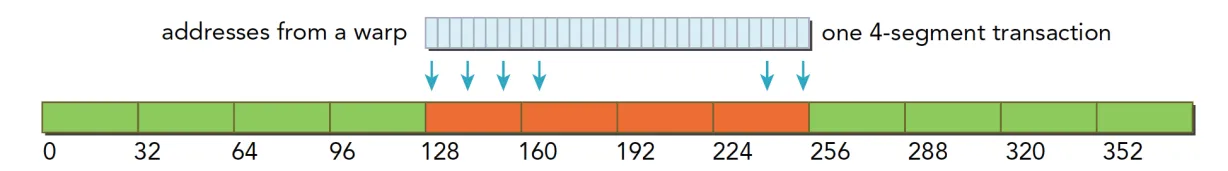
内存的存储和加载是完全不同的,并且存储相对简单很多。存储操作在32个字节的粒度上被执行,内存事务也被分为一段、两端或者四段,例如两个地址在一个 128 字节的段内但不在对齐的 64 字节区域内,则会产生一个四段的事务,执行四段的事务比执行两个一段事务的效果更好
Fermi 和 Kepler 架构的存储操作不经过 L1 ,只经过 L2
如下图所示,内存访问是对齐的,访问一个连续的 128 字节范围,存储请求使用一个四段事务完成,这里最理想的情况
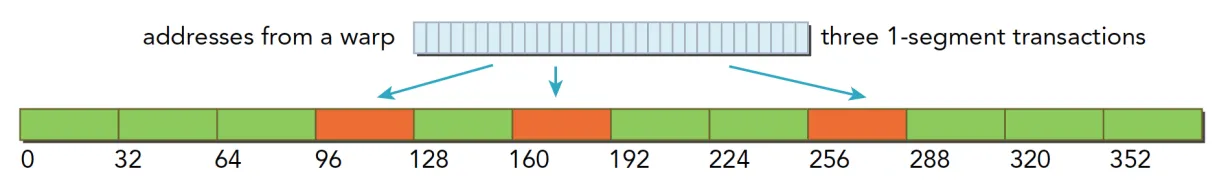
数据分散在一个 192 字节的范围内,存储不连续,使用三个一段事务实现
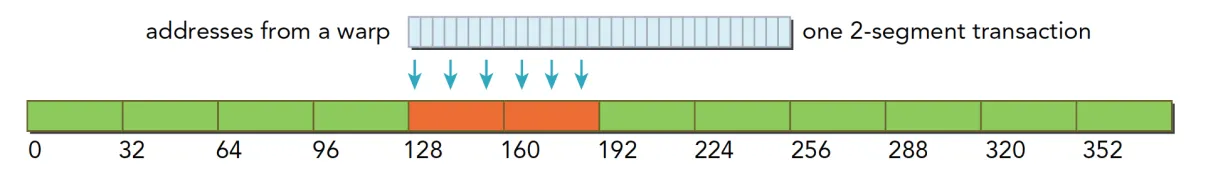
内存访问是对齐的,访问一个连续的 64 字节范围,存储请求使用一个两段事务完成
非对齐写入示例
只需要对核函数作如下修改即可
123456
__global__ void ArraySum(float*a, float*b, float*c, int offset, int n) {
    int i = blockIdx.x*blockDim.x+threadIdx.x;
    int k = i+offset;
    if(k < n)
        c[k] = a[i]+b[i];
}
测试结论与非对齐读取示例相同
结构体数组与数组结构体(SoA 和 AoS)
在 C 语言中,结构体是一种强大的数据组织方式,结构体中的成员在内存里对齐的依次排开,但是我们保存一组数据有两种方式,可以定义如下结构体
1234
struct S {
    float x;
    float y;
};
再定义一个数组结构体(AoS)
也可以定义一个结构体数组(SoA)
12345
struct S {
    float x[N];
    float y[N];
};
struct S _SoA[N];
AoS 方式组织的数据在空间上是相邻的,这在 CPU 上会有良好的缓存局部性,但是在 GPU 的并行架构中,读写一个结构体字段 x 时会同时加载 x 和 y 两个字段,这就导致有 50 % 的带宽损失,再看 SoA,访问一个 SoA 布局的结构体时,由于没有交叉存储的字段,所以是合并内存访问,可以充分利用带宽,图示如下
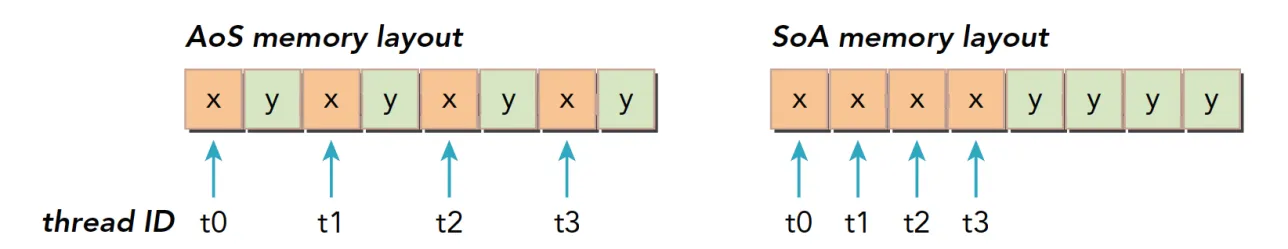
前面我们介绍的矩阵相乘中定义矩阵的结构体就是 SoA 方式,下面是 AoS 方式的代码,与 SoA 方式的代码作对比,只做测试用,无实际意义
这里指出第三章中矩阵相乘代码的错误,w 和 h 设置为 1 << 20 会导致数值溢出,这里改为1 << 12
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657
#include<cuda.h>
#include<cuda_runtime.h>
#include<stdio.h>

struct Matrix {
    int w;
    int h;
    float v;
};

__device__ int w = 1 << 12;
__device__ int h = 1 << 12;
__device__ float getValue(Matrix *A, int row, int col) {
    return A[row * w + col].v;
}

__device__ void setValue(Matrix *A, int row, int col, float v) {
    A[row * w + col].v = v;
}

__global__ void MatrixMul(Matrix *A, Matrix *B, Matrix *C) {
    float k = 0.0;
    int row = threadIdx.y + blockIdx.y * blockDim.y;
    int col = threadIdx.x + blockIdx.x * blockDim.x;
    for (int i=0; i < w; i++)
        k += getValue(A, row, i) * getValue(B, i, col);
    setValue(C, row, col, k);
}

int main() {
    int w = 1 << 12;
    int h = 1 << 12;
    Matrix *A, *B, *C;
    cudaMallocManaged((void**)&A, sizeof(Matrix) * w * h);
    cudaMallocManaged((void**)&B, sizeof(Matrix) * w * h);
    cudaMallocManaged((void**)&C, sizeof(Matrix) * w * h);
    for(int i=0; i < w*h; i++) {
        A[i].w = w;
        A[i].h = h;
        B[i].w = w;
        B[i].h = h;
        C[i].w = w;
        C[i].h = h;
        A[i].v = 1.0;
        B[i].v = 2.0;
        C[i].v = 0.0;
    }

    dim3 blockSize(32, 32);
    dim3 gridSize((w + blockSize.x - 1) / blockSize.x, (h + blockSize.y - 1) / blockSize.y);
    MatrixMul << < gridSize, blockSize >> >(A, B, C);
    cudaDeviceSynchronize();
    cudaFree(A);
    cudaFree(B);
    cudaFree(C);
    return 0;
}
使用 nsys 对比主机到设备的数据传输
123456789
# AoS 方式
Total (MB)  Count  Avg (MB)  Med (MB)  Min (MB)  Max (MB)  StdDev (MB)              Operation
 ----------  -----  --------  --------  --------  --------  -----------  ---------------------------------
    402.653   6951     0.058     0.016     0.004     1.040        0.143  [CUDA Unified Memory memcpy HtoD]

# SoA 方式
 Total (MB)  Count  Avg (MB)  Med (MB)  Min (MB)  Max (MB)  StdDev (MB)              Operation
 ----------  -----  --------  --------  --------  --------  -----------  ---------------------------------
    134.283   2772     0.048     0.008     0.004     1.028        0.142  [CUDA Unified Memory memcpy HtoD]
可以直观看到,AoS 对某个字段读写时会同时加载所有字段,Matrix结构体有三个字段,134 * 3 = 402,与数据显示一致
性能优化
优化设备内存带宽利用率有两个目标
- 对齐合并内存访问,减少带宽浪费
- 足够的并发内存操作,降低内存延迟
我们已经了解了如何组织内存访问以对内存对齐的内存访问,这可以在 DRAM 和 SM 片上内存或寄存器之间确保有效利用字节移动,实现内存访问最大化一般通过增加每个线程中执行独立内存操作的数量,以及对核函数启动的执行配置进行试验
展开循环
我们使用 8 循环展开技术对ArraySum核函数作修改
12345678910111213141516171819202122232425262728293031323334353637383940414243444546474849505152535455565758596061
#include <cuda_runtime.h>
#include <stdio.h>
__global__ void ArraySum(float*a, float*b, float*c, int n) {
    int i = blockIdx.x*blockDim.x*4 +threadIdx.x;
    c[i] = a[i]+b[i];
    if(i + blockDim.x < n)
        c[i+blockDim.x] = a[i+blockDim.x]+b[i+blockDim.x];
    if(i + blockDim.x *2 < n)
        c[i+blockDim.x *2] = a[i+blockDim.x *2]+b[i+blockDim.x *2];
    if(i + blockDim.x *3 < n)
        c[i+blockDim.x *3] = a[i+blockDim.x *3]+b[i+blockDim.x *3];
    if(i + blockDim.x *4 < n)
        c[i+blockDim.x *4] = a[i+blockDim.x *4]+b[i+blockDim.x *4];
    if(i + blockDim.x *5 < n)
        c[i+blockDim.x *5] = a[i+blockDim.x *5]+b[i+blockDim.x *5];
    if(i + blockDim.x *6 < n)
        c[i+blockDim.x *6] = a[i+blockDim.x *6]+b[i+blockDim.x *6];
    if(i + blockDim.x *7 < n)
        c[i+blockDim.x *7] = a[i+blockDim.x *7]+b[i+blockDim.x *7];
}

int main(int argc, char **argv) {

    int nElem=1<<28;
    int nBytes=sizeof(float)*nElem;

    dim3 block(1024);
    dim3 grid(nElem/block.x);

    float *A, *B, *C;

    cudaMallocManaged((float**)&A, nBytes);
    cudaMallocManaged((float**)&B, nBytes);
    cudaMallocManaged((float**)&C, nBytes);

    for(int i=0; i<nElem; i++) {
        A[i]=1.0;
        B[i]=2.0;
        C[i]=0.0;
    }

    cudaEvent_t start, stop;
    cudaEventCreate(&start);
    cudaEventCreate(&stop);
    cudaEventRecord(start, 0);

    ArraySum<<<grid.x/8, block>>>(A, B, C, nElem);
    cudaDeviceSynchronize();

    cudaEventRecord(stop, 0);
    cudaEventSynchronize(stop);
    float elapsedTime=0;
    cudaEventElapsedTime(&elapsedTime, start, stop);
    printf("<<<grid, block>>>: <<<%d,%d>>> Time elapsed: %f ms \n", grid.x/8, block.x, elapsedTime);

    cudaFree(A);
    cudaFree(B);
    cudaFree(C);

    return 0;
}
12
<<<grid, block>>>: <<<32768,1024>>> Time elapsed: 353.544189 ms
<<<grid, block>>>: <<<262144,1024>>> Time elapsed: 739.468262 ms
与最初的版本对比,循环展开技术节省了大半的运算时间
增大并行性
对数组求和所用的<<<grid, block>>>测试,寻找最佳执行配置
1234
<<<grid, block>>>: <<<262144,1024>>> Time elapsed: 865.561584 ms
<<<grid, block>>>: <<<524288,512>>> Time elapsed: 757.686401 ms
<<<grid, block>>>: <<<1048576,256>>> Time elapsed: 687.030212 ms
<<<grid, block>>>: <<<2097152,128>>> Time elapsed: 786.416626 ms
可以看到在block.x为 256 时,执行效率最高,这是因为较高的block.x会使 SM 的并行性降低,而过低的block.x不能充分利用 SM 的计算资源,具体的<<<grid, block>>>大小取决于当前的 GPU 架构中的 SM 配置,需要实验得出