摘要
多目标优化 ( MOO ) - Multi-Objective Optimization
从问题定义,单目标、多目标,无约束、有约束方面了解多目标优化
基础
无约束的单目标优化问题
min x f ( x ) , x ∈ R N
\min_{x} f(x),x \in R^{N}
x min f ( x ) , x ∈ R N 无约束的多目标优化问题
min x F ( x ) = [ f 1 ( x ) , f 2 ( x ) , ⋯ , f n ( x ) ] , x ∈ R N
\min_{x} F(x) = [f_1(x), f_2(x),\cdots, f_n(x)], x \in R^{N}
x min F ( x ) = [ f 1 ( x ) , f 2 ( x ) , ⋯ , f n ( x )] , x ∈ R N n n n f n ( x ) f_n(x) f n ( x ) F ( x ) F(x) F ( x )
有约束的单目标优化问题
min x f ( x ) s.t. g i ( x ) ≥ 0 , i ∈ [ 1 , M ] h j ( x ) = 0 , j ∈ [ 1 , L ]
\begin{array}{lcl}
\min_{x} & f(x) & \\
\text { s.t. } & g_{i}(x) \geq 0 & , i \in[1, M] \\
& h_{j}(x)=0 & , j \in[1, L]
\end{array}
min x s.t. f ( x ) g i ( x ) ≥ 0 h j ( x ) = 0 , i ∈ [ 1 , M ] , j ∈ [ 1 , L ] s.t. \text { s.t. } s.t. subject to ,受限于的缩写,设 D D D D = { x ∣ g i ( x ) ≥ 0 , i ∈ [ 1 , M ] , h j ( x ) = 0 , j ∈ [ 1 , L ] }
D = \{x | g_i(x) \geq 0, i \in [1, M], h_j(x) =0 , j \in [1,L] \}
D = { x ∣ g i ( x ) ≥ 0 , i ∈ [ 1 , M ] , h j ( x ) = 0 , j ∈ [ 1 , L ]}
有约束的多目标优化问题
min x F ( x ) = [ f 1 ( x ) , f 2 ( x ) , ⋯ , f n ( x ) ] s.t. g i ( x ) ≥ 0 , i ∈ ( 1 , M ) h j ( x ) = 0 , j ∈ ( 1 , L )
\begin{array}{lcl}
\min_x & F(x) = [f_1(x), f_2(x),\cdots, f_n(x)]\\
\text{s.t.} & g_i(x) \geq 0 ,\quad i\in(1, M) \\
& h_j(x) = 0 ,\quad j \in (1,L)
\end{array}
min x s.t. F ( x ) = [ f 1 ( x ) , f 2 ( x ) , ⋯ , f n ( x )] g i ( x ) ≥ 0 , i ∈ ( 1 , M ) h j ( x ) = 0 , j ∈ ( 1 , L ) 设 D D D D = { x ∣ g i ( x ) ≥ 0 , i ∈ [ 1 , M ] , h j ( x ) = 0 , j ∈ [ 1 , L ] }
D = \{x | g_i(x) \geq 0, i \in [1, M], h_j(x) =0 , j \in [1,L] \}
D = { x ∣ g i ( x ) ≥ 0 , i ∈ [ 1 , M ] , h j ( x ) = 0 , j ∈ [ 1 , L ]}
MOO 的解集
对于 MOO,通常没有解 x ∗ ∈ D x^\ast \in D x ∗ ∈ D f i ( x ) , ∀ i ∈ [ 1 , N ] f_i(x), \forall i \in [1,N] f i ( x ) , ∀ i ∈ [ 1 , N ]
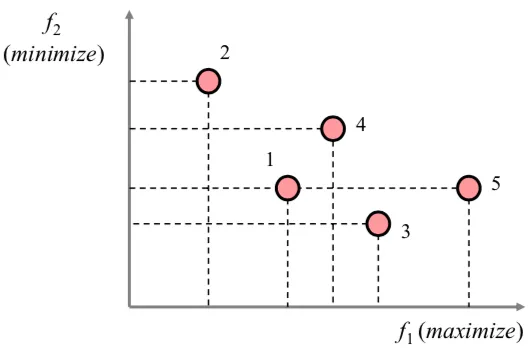
MOO 中的解集分为 绝对有效解 ,有效解 ,弱有效解
设 R N R^N R N N N N y = ( y 1 , y 2 , ⋯ , y N ) T y=(y_1,y_2,\cdots, y_N)^{T} y = ( y 1 , y 2 , ⋯ , y N ) T z = ( z 1 , z 2 , ⋯ , z N ) T z=(z_1,z_2,\cdots, z_N)^{T} z = ( z 1 , z 2 , ⋯ , z N ) T { 相等 y = z ⇔ y i = z i , i = 1 , 2 , … , N 严格小于 y < z ⇔ y i < z i , i = 1 , 2 , … , N 小于 y ≦ z ⇔ y i ⩽ z i , i = 1 , 2 , … , N 小于且不相等(支配) y ⩽ z ⇔ y i ⩽ z i , i = 1 , 2 , … , N , y ≠ z
\begin{cases}\text { 相等 } & y=z \Leftrightarrow y_{i}=z_{i}, i=1,2, \ldots, N \\ \text { 严格小于 } & y<z \Leftrightarrow y_{i}<z_{i}, i=1,2, \ldots, N \\ \text { 小于 } & y \leqq z \Leftrightarrow y_{i} \leqslant z_{i}, i=1,2, \ldots, N \\ \text { 小于且不相等(支配) } & y \leqslant z \Leftrightarrow y_{i} \leqslant z_{i}, i=1,2, \ldots, N, y \neq z\end{cases}
⎩ ⎨ ⎧ 相等 严格小于 小于 小于且不相等 ( 支配 ) y = z ⇔ y i = z i , i = 1 , 2 , … , N y < z ⇔ y i < z i , i = 1 , 2 , … , N y ≦ z ⇔ y i ⩽ z i , i = 1 , 2 , … , N y ⩽ z ⇔ y i ⩽ z i , i = 1 , 2 , … , N , y = z
Pareto 支配(Pareto Dominance)
∀ x 1 , x 2 ∈ R N \forall x_1, x_2 \in R^{N} ∀ x 1 , x 2 ∈ R N k = 1 , ⋯ , K k = 1,\cdots,K k = 1 , ⋯ , K f k ( x 1 ) ⩽ f k ( x 2 ) f_k(x_1) \leqslant f_k(x_2) f k ( x 1 ) ⩽ f k ( x 2 ) x 1 x_1 x 1 x 2 x_2 x 2
Pareto 解集(绝对最优解)
x ∗ ∈ D x^{\ast}{\in}{D} x ∗ ∈ D ∀ x ∈ D , f ( x ∗ ) ≦ f ( x ) \forall x \in D,\quad f(x^\ast) {\leqq} f(x) ∀ x ∈ D , f ( x ∗ ) ≦ f ( x ) ∀ k ∈ 1 , ⋯ , K , f K ( x ∗ ) ≦ f K ( x ) \forall k \in 1,\cdots,K, \quad f_K(x^\ast) \leqq f_{K}(x) ∀ k ∈ 1 , ⋯ , K , f K ( x ∗ ) ≦ f K ( x ) x ∗ x^\ast x ∗
Pareto 解集(有效解)
x ∗ ∈ D x^\ast\in{D} x ∗ ∈ D f k ( x ) ≤ f k ( x ∗ ) ∧ ∃ i , f i ( x ) < f i ( x ∗ ) , i ∈ [ 1 , k ] f_k(x)\leq f_k(x^\ast) \wedge \exists i,f_i(x) < f_i(x^\ast),i\in [1,k] f k ( x ) ≤ f k ( x ∗ ) ∧ ∃ i , f i ( x ) < f i ( x ∗ ) , i ∈ [ 1 , k ] x ∗ x^\ast x ∗ x ∗ x^\ast x ∗ x ∈ D x\in{D} x ∈ D f ( x ) f(x) f ( x ) f ( x ∗ ) f(x^\ast) f ( x ∗ ) f ( x ) f (x) f ( x ) f ( x ∗ ) f(x^\ast) f ( x ∗ ) x ∗ x^\ast x ∗
Pareto 解集(弱有效解)
x ∗ ∈ D x^\ast\in{D} x ∗ ∈ D x ∈ D x\in{D} x ∈ D f ( x ) < f ( x ∗ ) f(x)<f(x^\ast) f ( x ) < f ( x ∗ ) f k ( x ) < f k ( x ∗ ) ∧ ∀ k ∈ [ 1 , K ]
f_k(x) < f_k(x^*) \quad \wedge \quad \forall k \in [1,K]
f k ( x ) < f k ( x ∗ ) ∧ ∀ k ∈ [ 1 , K ] x ∗ x^\ast x ∗ x ∗ x^\ast x ∗ x ∈ D x\in{D} x ∈ D f ( x ) f(x) f ( x ) f ( x ∗ ) f(x^\ast) f ( x ∗ ) < < <
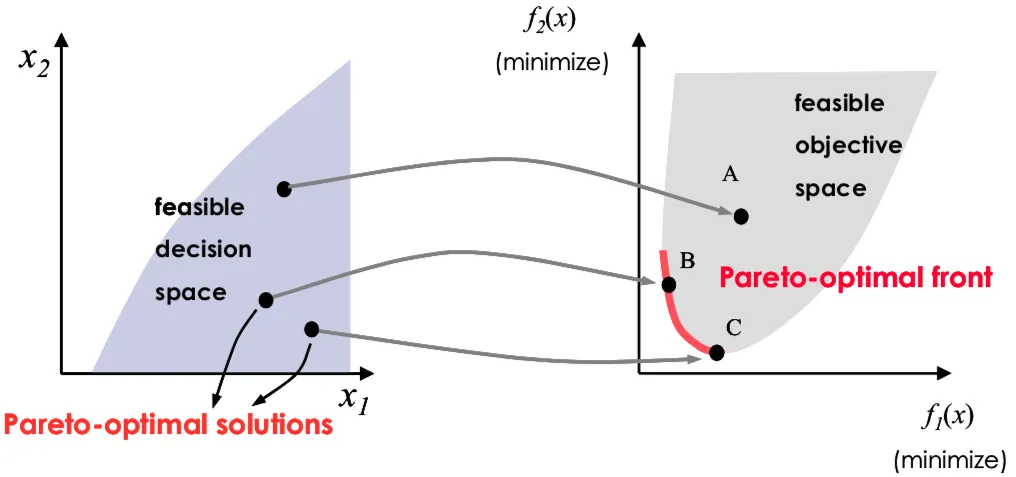
Pareto 最优解集(Pareto-optimal Set)
给定问题的有效解集(Pareto 最优解)构成的解集,集合中的解是相互非支配的,两两非支配关系,简称 P S PS P S
Pareto 最优前沿(Pareto-optimal Front)
Pareto 每一个解对应的目标值向量组成的集合,简称 P F PF P F P F = { F ( x ) ∣ x ∈ P S }
PF = \{F(x)|x\in PS\}
P F = { F ( x ) ∣ x ∈ P S }
MOO 的最优性条件
约束规格定义:对优化问题的约束函数,附加某些限制条件,使得其最优解满足的最优性条件
下面给出一个严格条件下多目标优化的充分必要条件,给出的充要条件前,先引入了约束规格条件
min x ∈ D ^ F ( x ) = ∑ k = 1 K f k ( x ) D ^ = x ∈ D ∣ f ( x ) ≤ f ( x ^ )
\begin{aligned}
\min _{x \in \hat{D}} F(x) &=\sum_{k=1}^{K} f_{k}(x) \\
\hat{D} &=x \in D \mid f(x) \leq f(\hat{x})
\end{aligned}
x ∈ D ^ min F ( x ) D ^ = k = 1 ∑ K f k ( x ) = x ∈ D ∣ f ( x ) ≤ f ( x ^ ) f ( x ) f (x) f ( x ) g ( x ) g(x) g ( x ) x ∈ D x \in D x ∈ D h ( x ) h(x) h ( x ) D ^ = x ∈ D ∣ f ( x ) ≤ f ( x ^ ) \hat{D} = x \in D|f (x) \leq f (\hat{x}) D ^ = x ∈ D ∣ f ( x ) ≤ f ( x ^ ) K K T KKT K K T x ∗ x^\ast x ∗ λ ∈ R K , u ∈ R M , v ∈ R L \lambda \in R^K , u \in R^M , v \in R^L λ ∈ R K , u ∈ R M , v ∈ R L { ∇ x L ( x ∗ , λ ∗ , u ∗ , v ∗ ) = ∇ f ( x ∗ ) λ ∗ + ∇ g ( x ∗ ) u ∗ + ∇ h ( x ∗ ) v ∗ = 0 u ∗ T g ( x ∗ ) = 0 λ ∗ > 0 , u ∗ ≥ 0
\left\{\begin{array}{l}
\nabla_{x} L\left(x^{*}, \lambda^{*}, u^{*}, v^{*}\right)=\nabla f\left(x^{*}\right) \lambda^{*}+\nabla g\left(x^{*}\right) u^{*}+\nabla h\left(x^{*}\right) v^{*}=0 \\
u^{* T} g\left(x^{*}\right)=0 \\
\lambda^{*}>0, u^{*} \geq 0
\end{array}\right.
⎩ ⎨ ⎧ ∇ x L ( x ∗ , λ ∗ , u ∗ , v ∗ ) = ∇ f ( x ∗ ) λ ∗ + ∇ g ( x ∗ ) u ∗ + ∇ h ( x ∗ ) v ∗ = 0 u ∗ T g ( x ∗ ) = 0 λ ∗ > 0 , u ∗ ≥ 0
MOO 的经典算法
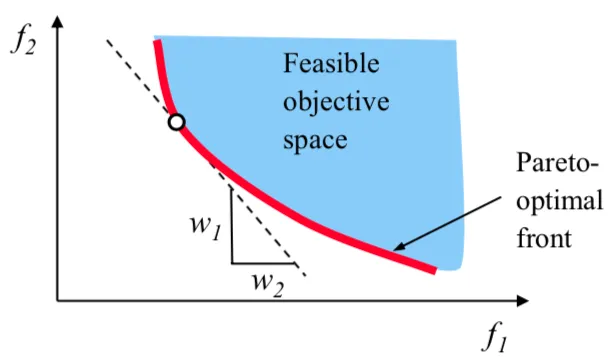
线性加权法
根据 f ( x ) f(x) f ( x ) min x ∑ k = 1 K λ k f k ( x ) s.t. g i ( x ) ≥ 0 , i ∈ [ 1 , M ] h j ( x ) = 0 , j ∈ [ 1 , L ]
\begin{array}{rl}
& \min _{x} \sum_{k=1}^{K} \lambda_{k} f_{k}(x) \\
\text { s.t. } & g_{i}(x) \geq 0,\quad i \in[1, M] \\
& h_{j}(x)=0,\quad j \in[1, L]
\end{array}
s.t. min x ∑ k = 1 K λ k f k ( x ) g i ( x ) ≥ 0 , i ∈ [ 1 , M ] h j ( x ) = 0 , j ∈ [ 1 , L ]
于是就变成了单目标优化问题,上述问题存在有效解的条件,对于给定的 λ ∈ Λ + + \lambda \in \Lambda^{++} λ ∈ Λ ++ Λ + + = { λ ∣ λ k > 0 , k = 1 , 2 … K , ∑ k = 1 K λ k = 1 }
\Lambda^{++}=\left\{\lambda \mid \lambda_{k}>0, k=1,2 \ldots K, \sum_{k=1}^{K} \lambda_{k}=1\right\}
Λ ++ = { λ ∣ λ k > 0 , k = 1 , 2 … K , k = 1 ∑ K λ k = 1 }
优点:实现简单,有成熟的算法求解
缺点:λ k \lambda_k λ k
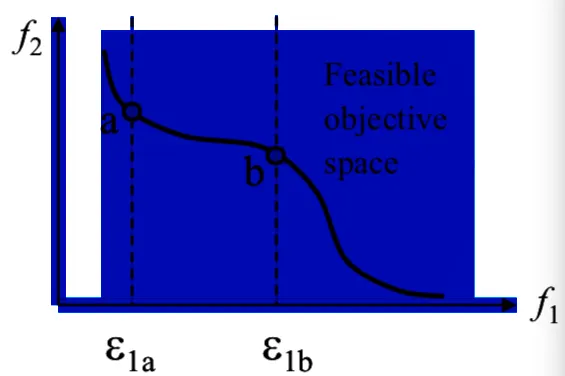
主要目标法
也称 ϵ \epsilon ϵ min x f p ( x ) s.t. f k ( x ) ≤ ϵ k k = 1 , … , K , k ≠ p g i ( x ) ≥ 0 i ∈ [ 1 , M ] h j ( x ) = 0 j ∈ [ 1 , L ]
\begin{array}{rlrl}
& \min _{x} & f_{p}(x) & \\
\text { s.t. } & f_{k}(x) &\leq \epsilon_{k} & k=1, \ldots, K, k \neq p \\
& g_{i}(x) &\geq 0 & i \in[1, M] \\
& h_{j}(x) &= 0 & j \in[1, L]
\end{array}
s.t. min x f k ( x ) g i ( x ) h j ( x ) f p ( x ) ≤ ϵ k ≥ 0 = 0 k = 1 , … , K , k = p i ∈ [ 1 , M ] j ∈ [ 1 , L ]
ϵ \epsilon ϵ K K K ϵ K \epsilon_{K} ϵ K
主要目标法最优解和 MOO 解集的关系
界限值 ϵ \epsilon ϵ
可以取子目标函数的上限值
min { f k ∣ f k ( x ) , k = 1 , … , K , k ≠ p } ≤ ϵ k
\min \left\{f_{k} \mid f_{k}(x), k=1, \ldots, K, k \neq p\right\} \leq \epsilon_{k}
min { f k ∣ f k ( x ) , k = 1 , … , K , k = p } ≤ ϵ k f k ( x ) f_k(x) f k ( x ) D ^ \hat{D} D ^ D ^ \hat{D} D ^ f k ( x ) f_k (x) f k ( x )
优点:简单,能应用到凸函数和非凸函数场景下
缺点:ϵ k \epsilon_k ϵ k D ^ \hat{D} D ^
逼近目标法
提出一个目标值 f 0 = ( f 1 0 , f 2 0 , ⋯ , f k 0 ) f^0 = (f_1^0,f_2^0,\cdots,f_k^0) f 0 = ( f 1 0 , f 2 0 , ⋯ , f k 0 ) f k ( x ) f_k(x) f k ( x ) L = ( f ( x ) , f 0 ) = ∣ ∣ f ( x ) − f 0 ∣ ∣ 2 λ = ∑ k = 1 K λ k ( f k ( x ) − f 0 ) 2 , λ ∈ Λ + +
\begin{array}{rl}
L = (f(x), f^0) & = ||f(x) - f^0 ||^{\lambda}_{2} \\
&= \sum_{k=1}^{K} \lambda_k(f_k(x)-f^0)^2,\lambda \in \Lambda^{++}
\end{array}
L = ( f ( x ) , f 0 ) = ∣∣ f ( x ) − f 0 ∣ ∣ 2 λ = ∑ k = 1 K λ k ( f k ( x ) − f 0 ) 2 , λ ∈ Λ ++
梯度下降算法
这是一种直接优化的方法,而上面提到的算法都是采取先验的知识将多目标优化转化成单目标优化
最速梯度下降
简单起见,将讨论问题限制在无约束的单目标优化问题,并要求无约束的单目标优化问题中的 f ( x ) f (x) f ( x ) f ( x ) f (x) f ( x ) D F ( x ; d ) = ∇ f ( x ) T d
DF(x;d) = \nabla f(x)^T d
D F ( x ; d ) = ∇ f ( x ) T d f ( x ) f(x) f ( x ) x x x min ∇ f ( x ) T d s.t. ∣ ∣ d ∣ ∣ ≤ 1
\min \nabla f(x)^T d \\
\text{s.t.} \quad ||d|| \leq 1
min ∇ f ( x ) T d s.t. ∣∣ d ∣∣ ≤ 1 ∣ ∣ ⋅ ∣ ∣ ||\cdot|| ∣∣ ⋅ ∣∣ d = − ∇ f ( x ) ∣ ∣ ∇ f ( x ) ∣ ∣
d = -\frac{\nabla f(x)}{||\nabla f(x)||}
d = − ∣∣∇ f ( x ) ∣∣ ∇ f ( x ) x t + 1 = x t + λ k d ( k )
x^{t+1} = x^t + \lambda_k d^{(k)}
x t + 1 = x t + λ k d ( k ) λ k \lambda _k λ k
多目标梯度下降算法
设当前为 t + 1 t+1 t + 1 x t + 1 = x t + λ ⋅ d t
x^{t+1} = x^t + \lambda \cdot d^{t}
x t + 1 = x t + λ ⋅ d t ∇ f k ( x ) T d , k = 1 , 2 , ⋯ , K
\nabla f_k(x)^T d,k = 1,2,\cdots,K
∇ f k ( x ) T d , k = 1 , 2 , ⋯ , K M x ( d t ) = m a x { ∇ f k ( x ) T d t ∣ k = 1 , 2 , ⋯ , K }
M_x(d^t) = max\{ \nabla f_k(x)^T d^t \mid k = 1,2,\cdots,K\}
M x ( d t ) = ma x { ∇ f k ( x ) T d t ∣ k = 1 , 2 , ⋯ , K } min M x ( d t ) + 1 2 ∥ d t ∥ 2 s.t. d t ∈ R
\begin{array}{l}
\min & M_x(d^t) + \frac{1}{2} \| d^t \| ^2 \\
\text{s.t.} & d^t \in R
\end{array}
min s.t. M x ( d t ) + 2 1 ∥ d t ∥ 2 d t ∈ R M x ( d t ) = α M_x (d^t) = \alpha M x ( d t ) = α min α + 1 2 ∥ d t ∥ 2 s.t. ∇ f k ( x ) T d t ≤ α , k = 1 , 2 , ⋯ , K d t ∈ R
\begin{array}{l}
\min & \alpha + \frac{1}{2} \|d^t \|^2 \\
\text{s.t.} & \nabla f_k(x)^T d^t \leq \alpha ,k = 1,2,\cdots,K \\
& d^t \in R
\end{array}
min s.t. α + 2 1 ∥ d t ∥ 2 ∇ f k ( x ) T d t ≤ α , k = 1 , 2 , ⋯ , K d t ∈ R
令 d ∗ d^\ast d ∗ a ∗ a^\ast a ∗
若 x ∗ x^\ast x ∗ d ∗ = 0 , a ∗ = 0 d^\ast=0,a^\ast=0 d ∗ = 0 , a ∗ = 0
若 x ∗ x^\ast x ∗ a ∗ < 0 a^\ast<0 a ∗ < 0
且
α ≤ − 1 2 ∥ d t ∣ 2 < 0 ∇ f k ( x ) T d t ≤ α , k = 1 , ⋯ , K
\alpha \leq-\frac{1}{2} \|\left. d^{t}\right|^{2}<0 \\
\nabla f_{k}(x)^{T} d^{t} \leq \alpha, k=1, \cdots, K
α ≤ − 2 1 ∥ d t 2 < 0 ∇ f k ( x ) T d t ≤ α , k = 1 , ⋯ , K
如果 d ∗ = 0 d^\ast = 0 d ∗ = 0
如果 d ∗ ≠ 0 d^\ast \neq 0 d ∗ = 0 ∇ f k ( x ) T d t < 0 \nabla f_{k}(x)^{T} d^{t} < 0 ∇ f k ( x ) T d t < 0 d t d^t d t
x ( t + 1 ) = x t + λ ⋅ d t f k ( x ( t + 1 ) ) ≤ f k ( x t ) , k = 1 , … , K
\begin{array}{l}
x^{(t+1)}&=& x^{t}+\lambda \cdot d^{t} \\
f_{k}\left(x^{(t+1)}\right) &\leq& f_{k}\left(x^{t}\right), k=1, \ldots, K
\end{array}
x ( t + 1 ) f k ( x ( t + 1 ) ) = ≤ x t + λ ⋅ d t f k ( x t ) , k = 1 , … , K 多任务学习(MTL)
多任务学习(MTL)- Multi-Task Learning
定义
在同一时间学习多个任务,求得最优解
设有 N N N { x , y i 1 , y i 2 , ⋯ , y i T } , i ∈ N \{ x,y_i^1,y_i^2,\cdots, y_i^T\},i \in N { x , y i 1 , y i 2 , ⋯ , y i T } , i ∈ N T T T y i t y_i^t y i t t t h t^{th} t t h i t h i^{th} i t h f t ( x ; θ s h , θ t ) : X → Y t
f^t(x;\theta^{sh},\theta^t):X \rightarrow Y^t
f t ( x ; θ s h , θ t ) : X → Y t θ s h \theta^{sh} θ s h θ t \theta^t θ t
L o s s Loss L oss L t ( _ , _ ) = Y t × Y t → R +
L^t(\_,\_) = Y^t \times Y^t \rightarrow R^+
L t ( _ , _ ) = Y t × Y t → R +
min θ s h , θ = ∑ t = 1 T c t L ^ t ( θ s h , θ )
\min_{\theta^{sh} ,\theta} = \sum_{t=1}^{T} c^t \hat{L}^{t}(\theta^{sh},\theta)
θ s h , θ min = t = 1 ∑ T c t L ^ t ( θ s h , θ ) c t c^t c t t t t L o s s Loss L oss L ^ t ( θ s h , θ ) ≜ 1 N ∑ t L ( f t ( x ; θ s h , θ t ) , y i t )
\hat{L}^t(\theta^{sh},\theta) \triangleq \frac{1}{N} \sum_t L(f^t(x;\theta^{sh}, \theta^t), y^t_i)
L ^ t ( θ s h , θ ) ≜ N 1 t ∑ L ( f t ( x ; θ s h , θ t ) , y i t )
多任务学习转化为多目标优化
将多任务学习转换为 MOO 问题求解,定义
min θ s h , θ L ( θ s h , θ 1 , … , θ T ) = min θ s h , θ ( L ^ 1 ( θ s h , θ 1 ) , ⋯ , L ^ T ( θ s h , θ T ) )
\min _{\theta^{s h}, \theta} L\left(\theta^{s h}, \theta^{1}, \ldots, \theta^{T}\right)=\min _{\theta^{s h}, \theta}\left(\hat{L}^{1}\left(\theta^{s h}, \theta^{1}\right), \cdots, \hat{L}^{T}\left(\theta^{s h}, \theta^{T}\right)\right)
θ s h , θ min L ( θ s h , θ 1 , … , θ T ) = θ s h , θ min ( L ^ 1 ( θ s h , θ 1 ) , ⋯ , L ^ T ( θ s h , θ T ) )
多目标优化的目的是求得 Pareto 最优解,多目标优化的 Pareto 最优解定义
一个解 θ \theta θ θ ˉ \bar{\theta} θ ˉ L ^ ( θ s h , θ t ) ≤ L ^ ( θ ˉ s h , θ ˉ t )
\hat{L}(\theta^{sh},\theta^t) \leq \hat{L}(\bar{\theta}^{sh},\bar{\theta}^t)
L ^ ( θ s h , θ t ) ≤ L ^ ( θ ˉ s h , θ ˉ t ) t t t L ( θ s h , θ 1 , θ 2 , ⋯ , θ T ) ≠ L ( θ ˉ s h , θ ˉ 1 , θ ˉ 2 , ⋯ , θ ˉ T )
L(\theta^{sh},\theta^1,\theta^2,\cdots,\theta^{T}) \neq L(\bar{\theta}^{sh},\bar{\theta}^1,\bar{\theta}^2,\cdots, \bar{\theta}^T)
L ( θ s h , θ 1 , θ 2 , ⋯ , θ T ) = L ( θ ˉ s h , θ ˉ 1 , θ ˉ 2 , ⋯ , θ ˉ T ) θ ∗ \theta^{\ast} θ ∗
多任务求解:单个 Pareto 解
问题转化
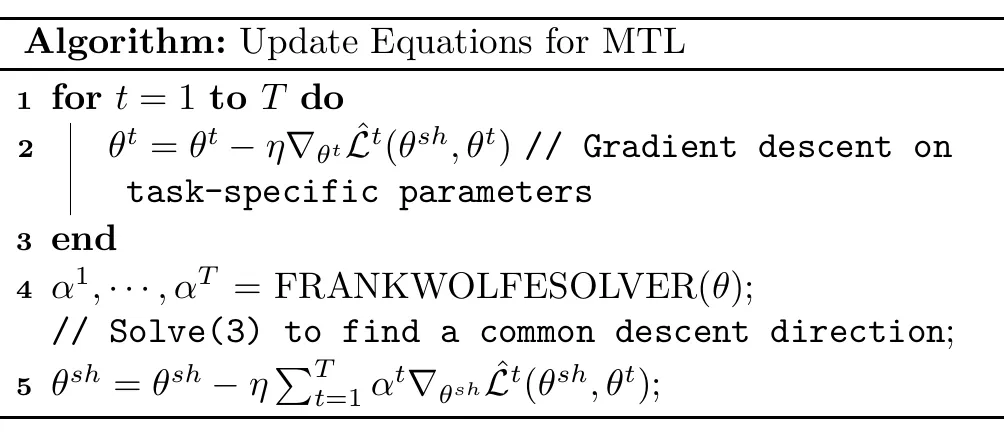
单个 Pareto 解使用了多重梯度下降法,由多目标优化的 K K T KKT K K T
存在 α 1 , α 2 , ⋯ , α T ≥ 0 \alpha^1,\alpha^2,\cdots,\alpha^T \geq 0 α 1 , α 2 , ⋯ , α T ≥ 0 ∑ t = 1 T α T = 1 ∑ t = 1 T α t ∇ θ s h L ^ ( θ s h , θ t ) = 0
\begin{array}{r}
\sum_{t=1}^{T} \alpha^T = 1 \\
\sum_{t=1}^{T} \alpha^t \nabla_{\theta^{sh}} \hat{L}(\theta^{sh},\theta^{t}) = 0
\end{array}
∑ t = 1 T α T = 1 ∑ t = 1 T α t ∇ θ s h L ^ ( θ s h , θ t ) = 0 t t t ∇ θ t L ^ ( θ s h , θ t ) = 0
\nabla_{\theta^t}\hat{L}(\theta^{sh},\theta^t) = 0
∇ θ t L ^ ( θ s h , θ t ) = 0 min α 1 , ⋯ , α T ∥ ∑ t = 1 T α t ∇ θ s h L ^ t ( θ s h , θ t ) ∥ ∑ t = 1 T α t = 1 , α t ≥ 0 , ∀ t
\begin{gathered}
\min _{\alpha^{1}, \cdots ,\alpha^{T}}\left\|\sum_{t=1}^{T} \alpha^{t} \nabla_{\theta s h} \hat{L}^{t}\left(\theta^{s h}, \theta^{t}\right)\right\| \\
\sum_{t=1}^{T} \alpha^{t}=1, \alpha^{t} \geq 0, \forall t
\end{gathered}
α 1 , ⋯ , α T min t = 1 ∑ T α t ∇ θ s h L ^ t ( θ s h , θ t ) t = 1 ∑ T α t = 1 , α t ≥ 0 , ∀ t
最优值 = 0 =0 = 0 K K T KKT K K T
最优值 ≠ 0 \neq 0 = 0
两个任务的情形
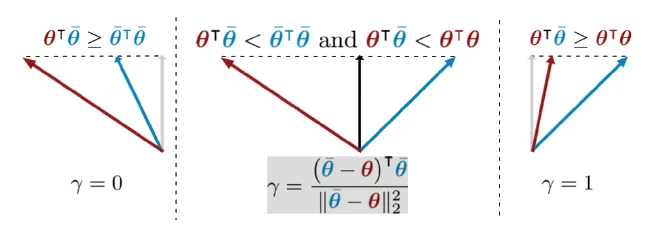
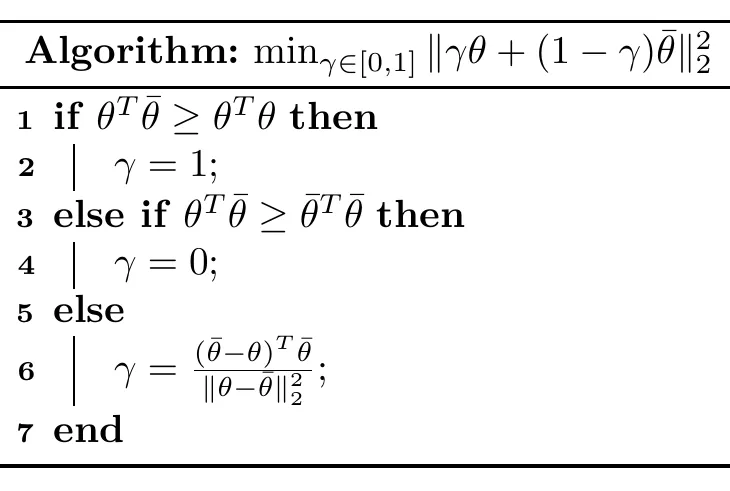
由多目标优化的 K K T KKT K K T min α 1 , … α T ∥ γ θ + ( 1 − γ ) θ ˉ ∥ γ + ( 1 − γ ) = 1 , γ ≥ 0
\begin{gathered}
\min _{\alpha^{1}, \ldots \alpha^{T}}\|\gamma \theta+(1-\gamma) \bar{\theta}\| \\
\gamma+(1-\gamma)=1, \gamma \geq 0
\end{gathered}
α 1 , … α T min ∥ γ θ + ( 1 − γ ) θ ˉ ∥ γ + ( 1 − γ ) = 1 , γ ≥ 0 θ , θ ˉ \theta,\bar{\theta} θ , θ ˉ θ ≜ ∇ θ s h L ^ 1 ( θ s h , θ 1 ) θ ˉ ≜ ∇ θ s h L ^ 2 ( θ s h , θ 2 )
\begin{aligned}
&\theta \triangleq \nabla_{\theta s h} \hat{L}^{1}\left(\theta^{s h}, \theta^{1}\right) \\
&\bar{\theta} \triangleq \nabla_{\theta s h} \hat{L}^{2}\left(\theta^{s h}, \theta^{2}\right)
\end{aligned}
θ ≜ ∇ θ s h L ^ 1 ( θ s h , θ 1 ) θ ˉ ≜ ∇ θ s h L ^ 2 ( θ s h , θ 2 )
当 θ T θ ˉ ≥ θ T θ , γ = 1 \theta^T \bar{\theta} \geq \theta^T \theta,\gamma = 1 θ T θ ˉ ≥ θ T θ , γ = 1
当 θ T θ ˉ ≥ θ ˉ T θ ˉ , γ = 0 \theta^T \bar{\theta} \geq \bar{\theta}^T \bar{\theta},\gamma = 0 θ T θ ˉ ≥ θ ˉ T θ ˉ , γ = 0
otherwise \text{otherwise} otherwise
γ = ( θ ˉ − θ ) T θ ˉ ∥ θ ˉ − θ ) ∥ 2 2 p 7
\gamma=\frac{(\bar{\theta}-\theta)^{T} \bar{\theta}}{\| \bar{\theta}-\theta) \|_{2}^{2}}p7
γ = ∥ θ ˉ − θ ) ∥ 2 2 ( θ ˉ − θ ) T θ ˉ p 7 几何解释
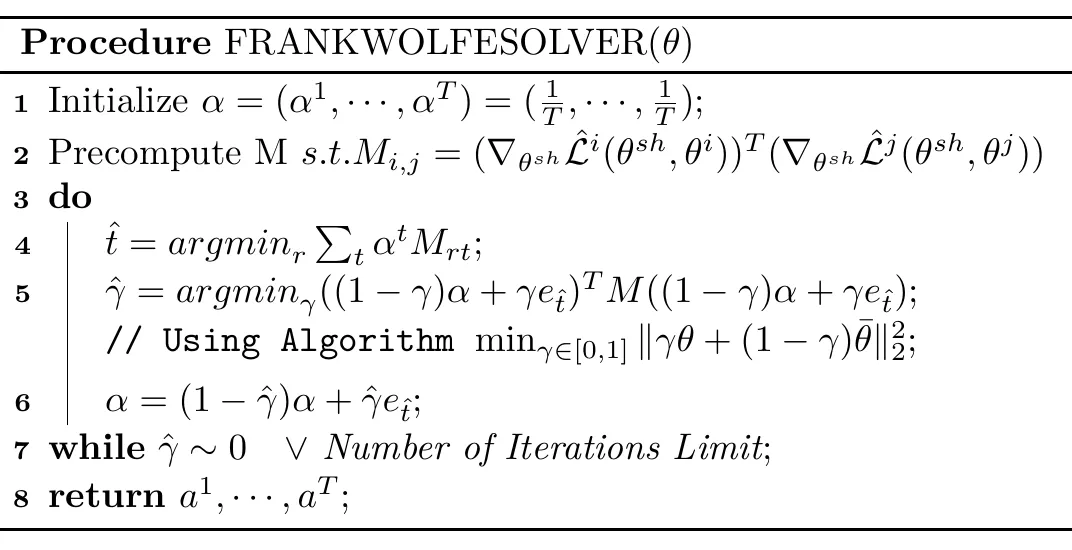
基于 Frank-wolfe 算法,得求解 MTL 任务算法
多任务求解:多个 Pareto 解
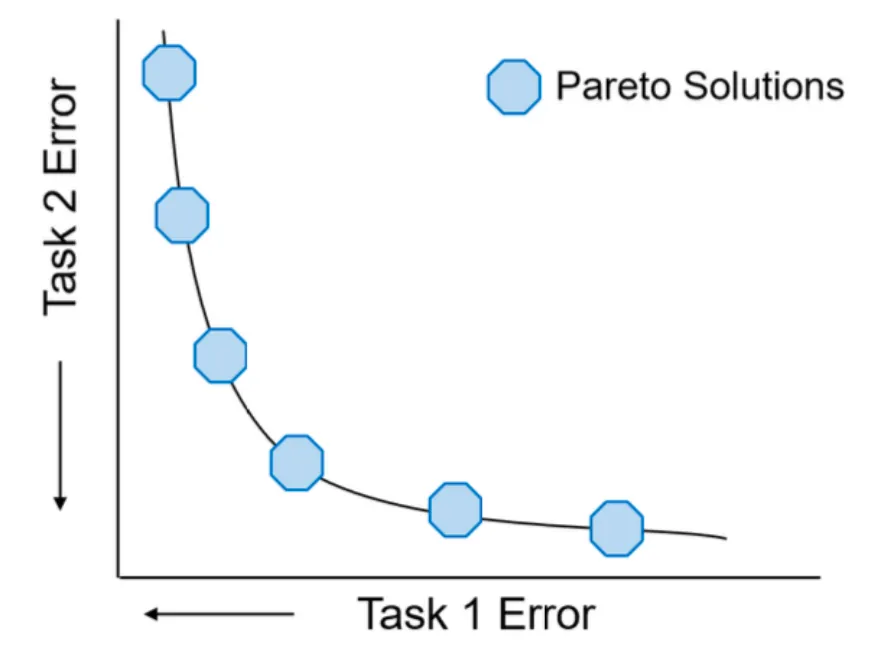
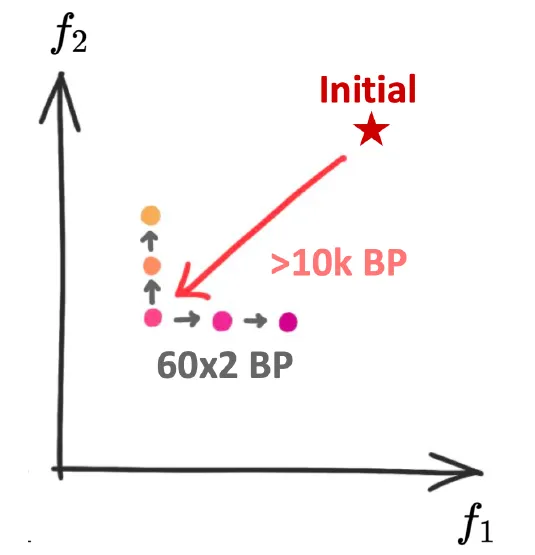
上一节介绍的方法只能求得一个 pareto 解,有时需要多个 pareto 解才能做出更好的决策
主要思想
将多任务学习分解为多个带约束的多目标子问题,通过对子问题进行并行求解
原始多任务学习定义
min θ L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , ⋯ , L i ( θ ) , ⋯ , L m ( θ ) )
\min_{\theta} L(\theta) = (L_1(\theta),L_2(\theta),\cdots,L_i(\theta),\cdots,L_m(\theta))
θ min L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , ⋯ , L i ( θ ) , ⋯ , L m ( θ )) L i ( θ ) L_i(\theta) L i ( θ ) i i i
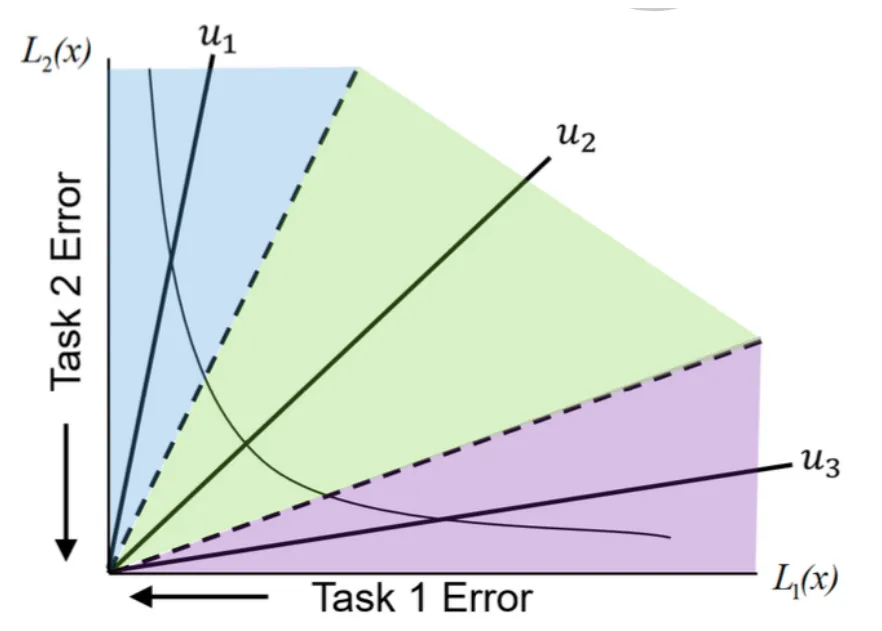
下图所示
用一组分布良好的 Preference Vectors(PV)将多任务学习的目标空间分解为 K K K P V = { u 1 , u 2 , ⋯ , u k , ⋯ , u K } , u k ∈ R + m
PV = \{u_1,u_2,\cdots,u_k,\cdots,u_K\},u_k \in R_+^m
P V = { u 1 , u 2 , ⋯ , u k , ⋯ , u K } , u k ∈ R + m min θ L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , L m ( θ ) ) s . t . L ( θ ) ∈ Ω k , k = 1 , ⋯ , K
\min_{\theta} L(\theta) = (L_1(\theta),L_2(\theta),L_m(\theta)) \\
s.t. \quad L(\theta) \in \Omega_k,k = 1,\cdots,K
θ min L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , L m ( θ )) s . t . L ( θ ) ∈ Ω k , k = 1 , ⋯ , K Ω k \Omega_k Ω k Ω k = { v ∈ R + m ∣ u j T v ≤ u k T v , ∀ j = 1 , ⋯ , K }
\Omega_k = \{v \in R_+^m | u_j^T v \leq u_k^Tv,\forall j = 1,\cdots,K \}
Ω k = { v ∈ R + m ∣ u j T v ≤ u k T v , ∀ j = 1 , ⋯ , K } Ω k \Omega_k Ω k v v v v ∈ Ω k ⇔ u k T v = ∥ u k ∥ ⋅ ∥ v ∥ cos α
v \in \Omega_k \Leftrightarrow u_k^T v = \| u_k \| \cdot \| v \| \cos{\alpha}
v ∈ Ω k ⇔ u k T v = ∥ u k ∥ ⋅ ∥ v ∥ cos α u k T v u_k^T v u k T v
重新定义多任务学习
min θ L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , L m ( θ ) ) s.t. G j ( θ t ) = ( u j − u k ) T L ( θ t ) ≤ 0 j = 1 , ⋯ , K
\begin{array}{rl}
& \min_\theta L(\theta) = (L_1(\theta),L_2(\theta),L_m(\theta)) \\
\text{s.t.} & G_j(\theta_t) = (u_j - u_k)^T \\
& L(\theta_t) \leq 0 \\
& j=1,\cdots,K
\end{array}
s.t. min θ L ( θ ) = ( L 1 ( θ ) , L 2 ( θ ) , L m ( θ )) G j ( θ t ) = ( u j − u k ) T L ( θ t ) ≤ 0 j = 1 , ⋯ , K Ω k \Omega_k Ω k
子问题的梯度下降方法
寻找初始解 θ r \theta_r θ r
求解多任务学习,需要找到一个满足约束的基本可行解,对于随机产生的可行解 θ r \theta_r θ r θ 0 \theta_0 θ 0 min θ 0 ∥ θ 0 − θ r ∥ 2 s.t. L ( θ 0 ) ∈ Ω k
\begin{array}{l}
& \min_{\theta_0} \| \theta_0 - \theta_r \|^2 \\
\text{s.t.} & L(\theta_0) \in \Omega_k
\end{array}
s.t. min θ 0 ∥ θ 0 − θ r ∥ 2 L ( θ 0 ) ∈ Ω k θ 0 \theta_0 θ 0
定义活跃限制集合(activated constraints)
I ( θ r ) = { j ∣ G j ( θ r ) ≥ 0 , j = 1 , ⋯ , K }
I(\theta_r) = \{ j|G_j(\theta_r) \geq 0,j=1,\cdots,K \}
I ( θ r ) = { j ∣ G j ( θ r ) ≥ 0 , j = 1 , ⋯ , K } I ( θ r ) I(\theta_r) I ( θ r ) ( d r , α r ) = argmin d ∈ R n , α ∈ R α + 1 2 ∥ d ∥ 2 s.t. ∇ G j ( θ r ) T d ≤ α , j ∈ I ( θ r )
(d_r,\alpha_r) = \text{argmin}_{d \in R^n,\alpha \in R} \quad \alpha + \frac{1}{2} \|d\|^2 \\
\text{s.t.} \quad \nabla G_j (\theta_r)^T d \leq \alpha,j\in I(\theta_r)
( d r , α r ) = argmin d ∈ R n , α ∈ R α + 2 1 ∥ d ∥ 2 s.t. ∇ G j ( θ r ) T d ≤ α , j ∈ I ( θ r ) θ r t + 1 = θ r t + η r d r t
\theta_{r_{t+1}} = \theta_{r_t} + \eta_r d_{r_t}
θ r t + 1 = θ r t + η r d r t I ( θ r ) I(\theta_{r}) I ( θ r ) θ r \theta_{r} θ r
求解子问题
受限 pareto 最优:θ ∗ \theta^{\ast} θ ∗ L ( θ ) L(\theta) L ( θ ) Ω k \Omega_k Ω k θ ∗ ∈ Ω k \theta^{\ast} \in \Omega_k θ ∗ ∈ Ω k θ ^ ∈ Ω k \hat{\theta} \in \Omega_k θ ^ ∈ Ω k θ ^ < θ ∗ \hat{\theta} < \theta^{\ast} θ ^ < θ ∗
考虑如下多目标优化问题
$$
\begin{array}{l}
& (d_t,\alpha_t) = \text{argmin}_{d\in R^n,\alpha \in R} \quad \alpha + \frac{1}{2}|d|^2 \
\text{s.t.} & \nabla L_i(\theta_t)^Td \leq \alpha,i=1,\cdots,m\
& \nabla G_j(\theta_t)^Td \leq \alpha,j \in I_{\in}(\theta_t)
\end{array}
$$
其中 I ∈ ( θ t ) I_{\in}(\theta_t) I ∈ ( θ t ) I ∈ ( θ t ) = { j ∈ I ∣ G j ( θ ) ≥ − ϵ }
I_{\in} (\theta_t) = \{j \in I | G_j (\theta) \geq - \epsilon \}
I ∈ ( θ t ) = { j ∈ I ∣ G j ( θ ) ≥ − ϵ } ( d k , a k ) (d^k,a^k) ( d k , a k )
如果 θ t \theta_t θ t Ω k \Omega_k Ω k d t = 0 ∈ R n d_t = 0 \in R^n d t = 0 ∈ R n α t = 0 \alpha_t = 0 α t = 0
如果 θ t \theta_t θ t Ω k \Omega_k Ω k α t ≤ − 1 2 ∥ d t ∥ 2 < 0 ∇ L i ( θ t ) T d ≤ α , i = 1 , … , m ∇ G j ( θ t ) T d ≤ α , j ∈ I ϵ ( θ t )
\begin{array}{l}
\alpha_{t} \leq-\frac{1}{2}\left\|d_{t}\right\|^{2}<0 \\
\nabla L_{i}\left(\theta_{t}\right)^{T} d \leq \alpha,& i=1, \ldots, m \\
\nabla G_{j}\left(\theta_{t}\right)^{T} d \leq \alpha,& j \in I_{\epsilon}\left(\theta_{t}\right)
\end{array}
α t ≤ − 2 1 ∥ d t ∥ 2 < 0 ∇ L i ( θ t ) T d ≤ α , ∇ G j ( θ t ) T d ≤ α , i = 1 , … , m j ∈ I ϵ ( θ t ) θ t + 1 = θ t + η d t
\theta_{t+1} = \theta_t + \eta d_t
θ t + 1 = θ t + η d t
通过求解上述问题,能够获得一个有效的搜索方向
大规模求解方法
上述方法能够获得一个有效的搜索方向,对于大规模的问题,会比较困难,这里将问题重写,将其表示为对偶形式
K K T KKT K K T d t = − ∑ i = 1 m λ i ∇ L i ( θ t ) + ∑ j ∈ I ϵ ( θ ) β i ∇ G j ( θ t ) s.t. ∑ i = 1 m λ i + ∑ j ∈ I ϵ ( θ ) β j = 1
\begin{array}{l}
& d_{t} =-\sum_{i=1}^{m} \lambda_{i} \nabla L_{i}\left(\theta_{t}\right)+\sum_{j \in I_{\epsilon}(\theta)} \beta_{i} \nabla G_{j}\left(\theta_{t}\right) \\
\text{s.t.} & \sum_{i=1}^{m} \lambda_{i}+\sum_{j \in I_{\epsilon}(\theta)} \beta_{j}=1
\end{array}
s.t. d t = − ∑ i = 1 m λ i ∇ L i ( θ t ) + ∑ j ∈ I ϵ ( θ ) β i ∇ G j ( θ t ) ∑ i = 1 m λ i + ∑ j ∈ I ϵ ( θ ) β j = 1
对偶问题
max λ i , β j − 1 2 ∥ ∑ i = 1 m λ i ∇ L i ( θ t ) + ∑ j ∈ I ϵ ( θ ) β i ∇ G j ( θ t ) ∥ 2 s.t. ∑ i = 1 m λ i + ∑ j ∈ I ϵ ( θ ) β j = 1 λ i ≥ 0 , β j ≥ 0 ∀ i = 1 , ⋯ , m ∀ j ∈ I ϵ ( θ )
\begin{array}{l}
& \max_{\lambda_{i}, \beta_{j}}-\frac{1}{2}\left\|\sum_{i=1}^{m} \lambda_{i} \nabla L_{i}\left(\theta_{t}\right)+\sum_{j \in I_{\epsilon}(\theta)} \beta_{i} \nabla G_{j}\left(\theta_{t}\right)\right\|^{2} \\
\text { s.t. } & \sum_{i=1}^{m} \lambda_{i}+\sum_{j \in I_{\epsilon}(\theta)} \beta_{j}=1 \\
& \lambda_{i} \geq 0, \beta_{j} \geq 0 \\
& \forall i=1, \cdots, m\\
& \forall j \in I_{\epsilon}(\theta)
\end{array}
s.t. max λ i , β j − 2 1 ∑ i = 1 m λ i ∇ L i ( θ t ) + ∑ j ∈ I ϵ ( θ ) β i ∇ G j ( θ t ) 2 ∑ i = 1 m λ i + ∑ j ∈ I ϵ ( θ ) β j = 1 λ i ≥ 0 , β j ≥ 0 ∀ i = 1 , ⋯ , m ∀ j ∈ I ϵ ( θ )
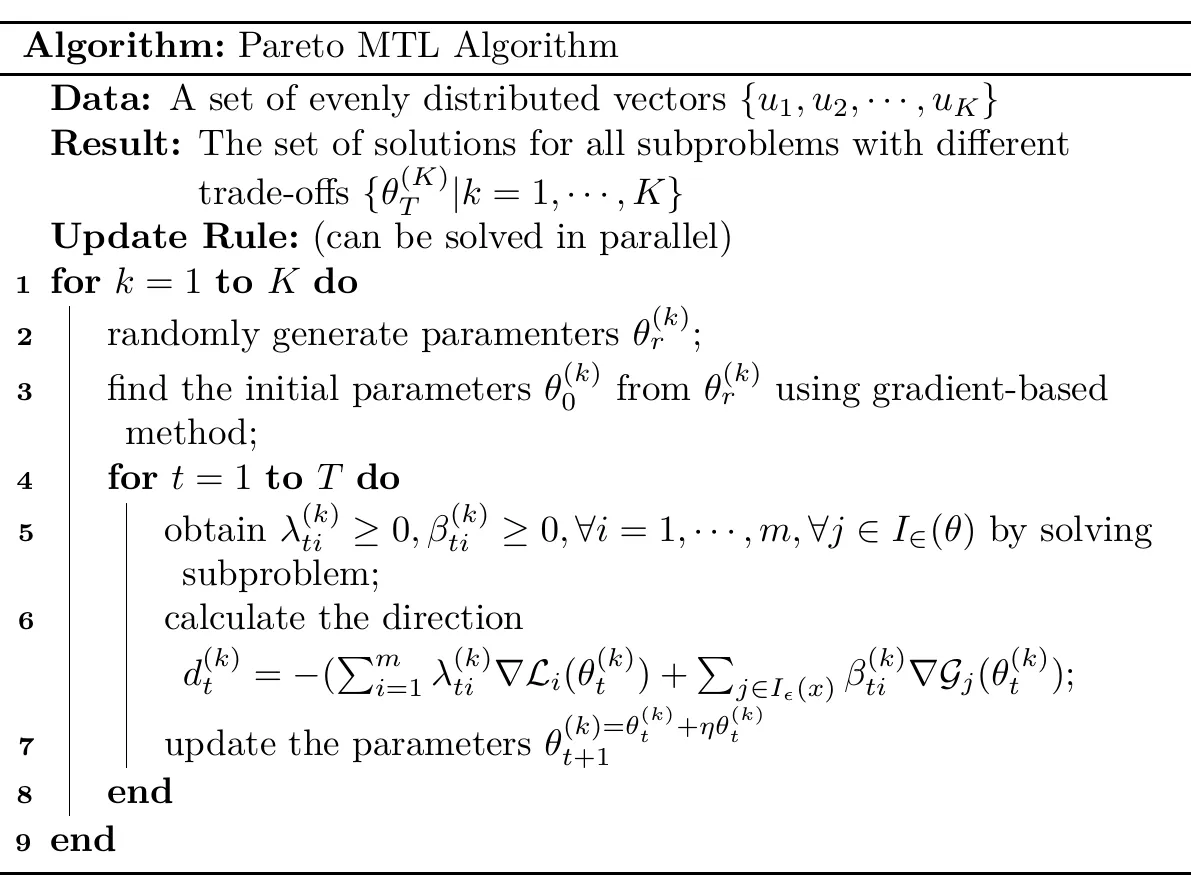
将多任务学习转化为其对偶问题后,求解空间不再是参数空间,而是变成了任务个数和受限条件数,使得求解问题极大的减少了
Pareto MTL 算法如下图
为表述方便,这里引用论文中关于多任务学习的定义
设 f ( x ) f(x) f ( x ) f ( x ) : R n → R m f i ( x ) : R n → R , i = 1 , ⋯ , m
f(x):\mathcal{R}^n \rightarrow \mathcal{R}^m \\
f_i(x):\mathcal{R}^n \rightarrow \mathcal{R},i=1,\cdots,m
f ( x ) : R n → R m f i ( x ) : R n → R , i = 1 , ⋯ , m
准备:K r y l o v Krylov K r y l o v
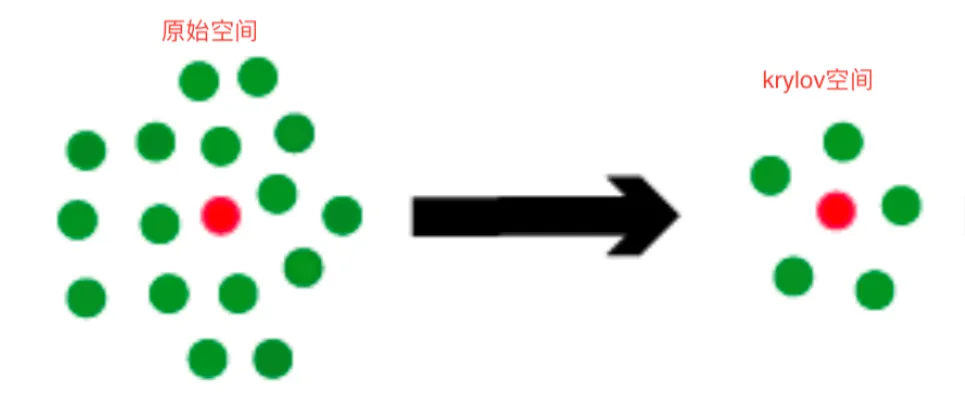
大规模稀疏线性方程组 A X = b AX=b A X = b k r y l o v krylov k r y l o v K ⊂ R n \mathcal{K} \subset R_n K ⊂ R n
定义:设 A ∈ R n × n , r ∈ R n A \in R^{n \times n},r \in R^n A ∈ R n × n , r ∈ R n K m ( A , r ) ≜ span { r , A r , ⋯ , A m − 1 r } ⊆ R n
\mathcal{K}_{m}(A, r) \triangleq \text{span}\{r, Ar, \cdots, A^{m-1} r\} \subseteq R_{n}
K m ( A , r ) ≜ span { r , A r , ⋯ , A m − 1 r } ⊆ R n A A A r r r K r y l o v Krylov K r y l o v K m \mathcal{K}_m K m K r y l o v Krylov K r y l o v
K r y l o v Krylov K r y l o v K 1 ⊆ K 2 ⊆ ⋯ ⊆ K m \mathcal{K}_{1} \subseteq \mathcal{K}_{2} \subseteq \cdots \subseteq \mathcal{K}_{m} K 1 ⊆ K 2 ⊆ ⋯ ⊆ K m K m \mathcal{K}_m K m m m m K m ( A , r ) = { x = p ( A ) } \mathcal{K}_{m}(A, r)=\{x=p(A)\} K m ( A , r ) = { x = p ( A )} r r r m m m
求解 K r y l o v Krylov K r y l o v
基本概念
Pareto 平稳点(Pareto Stationary):设 f i ( x ) f_i(x) f i ( x ) x x x α ∈ R m , a i ≥ 0 \alpha \in \mathcal{R}^{m},a_i \geq 0 α ∈ R m , a i ≥ 0 ∑ i = 1 m α i ∇ f i ( x ) = 0 ∑ i = 1 m α i = 1
\sum_{i=1}^{m} \alpha_i \nabla f_i(x) = 0 \\
\sum_{i=1}^{m} \alpha_i = 1
i = 1 ∑ m α i ∇ f i ( x ) = 0 i = 1 ∑ m α i = 1
Pareto 点都是 Pareto 平稳点
设 f ( x ) f(x) f ( x ) x ∗ x^{\ast} x ∗ x ( t ) x(t) x ( t ) x ∗ x^{\ast} x ∗ x ( t ) : t ∈ ( − ϵ , ϵ ) → R n x ( 0 ) = x ∗
x(t):t\in (-\epsilon,\epsilon) \rightarrow \mathcal{R}^n \\
x(0) = x^{\ast}
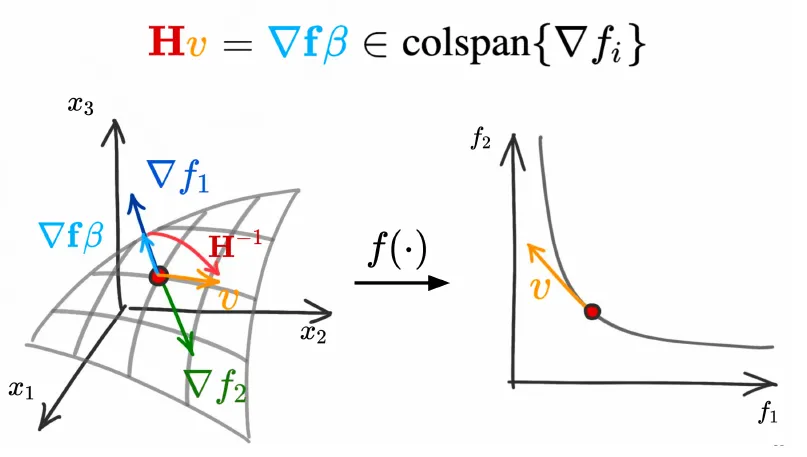
x ( t ) : t ∈ ( − ϵ , ϵ ) → R n x ( 0 ) = x ∗ β ∈ R m \beta \in \mathcal{R}^m β ∈ R m H ( x ∗ ) x ′ ( t ) = ∇ f ( x ∗ ) T β H ( x ∗ ) = ∑ i = 1 m α i ∇ 2 f i ( x ∗ )
H(x^{\ast})x'(t) = \nabla f(x^{\ast})^T \beta \\
H(x^{\ast}) = \sum_{i=1}^{m} \alpha_i \nabla^2 f_i(x^{\ast})
H ( x ∗ ) x ′ ( t ) = ∇ f ( x ∗ ) T β H ( x ∗ ) = i = 1 ∑ m α i ∇ 2 f i ( x ∗ ) x ′ ( t ) x'(t) x ′ ( t )
上式表明,算子 H ( x ∗ ) H(x^{\ast}) H ( x ∗ ) x x x v = x ′ ( t ) v = x'(t) v = x ′ ( t ) ∇ f i ( x ∗ ) ∇f_i(x^{\ast}) ∇ f i ( x ∗ ) K r y l o v Krylov K r y l o v
离散 Pareto 求解
给定初始点 x 0 ∈ R n , f i ( x ) x_0 \in \mathcal{R}^n,f_i(x) x 0 ∈ R n , f i ( x )
求解 Pareto 平稳点: 从初始点 x 0 x_0 x 0 x 0 ∗ x_0^{\ast} x 0 ∗
扩展 Pareto 平稳点,f ( x ) f(x) f ( x ) x 0 ∗ x_0^{\ast} x 0 ∗ x 0 ∗ x_0^{\ast} x 0 ∗ x i ∗ x_i^{\ast} x i ∗
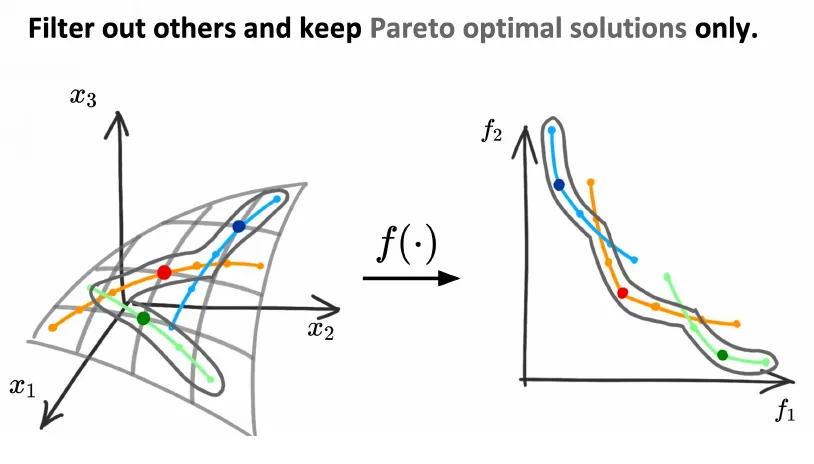
将已知的平稳点所在的局部 Pareto 前沿进行连接合并,扩充成更大的连续Pareto 前沿
接下来讨论获取 Pareto 平稳点的方法
梯度求解法
见上述
一阶梯度求解法扩张
通过梯度求解法求解出 Pareto 平稳点 x 0 ∗ x_0^{\ast} x 0 ∗ { x i } \{x_i \} { x i }
计算权重 α \alpha α
求解搜索方向 v v v v i v_i v i
通过如下更新公式求解
x i = x 0 ∗ + s v i
x_i = x_0^{\ast} + sv_i
x i = x 0 ∗ + s v i α \alpha α min α ∥ ∑ i = 1 m α i ∇ f i ( x 0 ∗ ) ∥ 2 s.t. α i ≥ 0 , ∑ i = 1 m α i = 1
\min_\alpha \| \sum_{i=1}^m \alpha_i \nabla f_i(x_0^{\ast}) \|^2 \\
\text{s.t.} \quad \alpha_i \geq 0,\sum_{i=1}^m \alpha_i = 1
α min ∥ i = 1 ∑ m α i ∇ f i ( x 0 ∗ ) ∥ 2 s.t. α i ≥ 0 , i = 1 ∑ m α i = 1 m m m
再由基本概念,得求解的线性方程组
H ( x 0 ∗ ) v = ∇ f ( x 0 ∗ ) T β
H(x_0^{\ast})v = \nabla f(x_0^{\ast})^T \beta
H ( x 0 ∗ ) v = ∇ f ( x 0 ∗ ) T β
x 0 ∗ x_0^{\ast} x 0 ∗ 当 n n n
为此引入校正向量 c c c min a , c ∥ c ∥ 2 s.t. α i ≥ 0 ∑ i = 1 m α i = 1 ∑ i = 1 m α i ( ∇ f i ( x 0 ∗ ) − c ) = 0
\begin{array}{l}
&\min_{a,c} \| c \|^2 \\
\text{s.t.} & \alpha_i \geq 0 \\
& \sum_{i=1}^m \alpha_i = 1 \\
& \sum_{i=1}^{m} \alpha_i(\nabla f_i(x_0^{\ast})-c)=0
\end{array}
s.t. min a , c ∥ c ∥ 2 α i ≥ 0 ∑ i = 1 m α i = 1 ∑ i = 1 m α i ( ∇ f i ( x 0 ∗ ) − c ) = 0 ∇ f i ( x 0 ∗ ) − c \nabla f_i(x_0^{\ast})-c ∇ f i ( x 0 ∗ ) − c ∇ f i ( x 0 ∗ ) \nabla f_i(x_0^{\ast}) ∇ f i ( x 0 ∗ ) x 0 ∗ x_0^{\ast} x 0 ∗
设 a ∗ a^{\ast} a ∗ c c c ( a , c ) = ( a ∗ , ∇ f ( x 0 ∗ ) T a ∗ )
(a,c) = (a^{\ast},\nabla f(x_0^{\ast})^T a^{\ast})
( a , c ) = ( a ∗ , ∇ f ( x 0 ∗ ) T a ∗ ) a ∗ , x 0 ∗ , c a^{\ast},x_0^{\ast},c a ∗ , x 0 ∗ , c ∇ f ( x 0 ∗ ) \nabla f(x_0^{\ast}) ∇ f ( x 0 ∗ ) H ( x 0 ∗ ) v = ( ∇ f ( x 0 ∗ ) T − c T ) β
H(x_0^{\ast})v = (\nabla f(x_0^{\ast})^T - c^T) \beta
H ( x 0 ∗ ) v = ( ∇ f ( x 0 ∗ ) T − c T ) β β \beta β v v v k r y l o v krylov k r y l o v M I N E R S MINERS M I N E R S
寻找离散 Pareto 解集合的求解算法
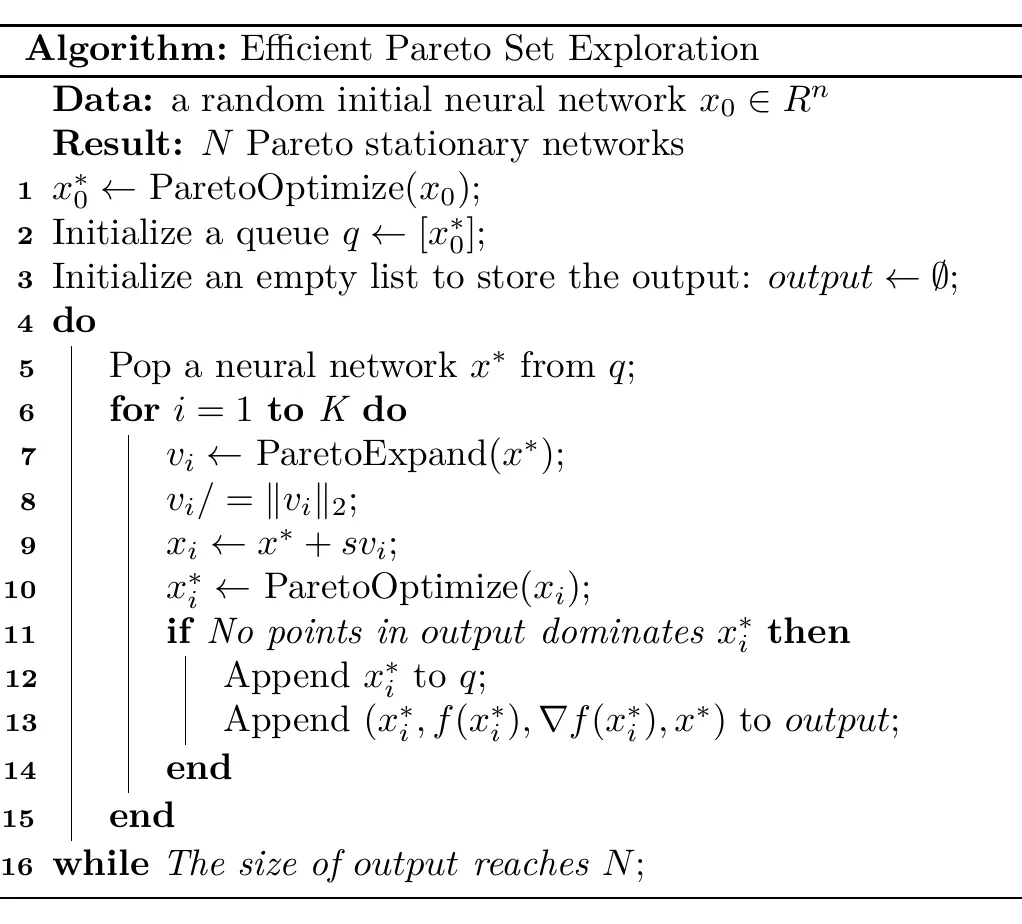
Input:随机初始化网络
ParetoExpand(x ∗ x^{\ast} x ∗ x ∗ x^{\ast} x ∗ K K K v i v_i v i
由 K K K K K K
更新子网络节点 x i = x ∗ + s v i x_i = x^{\ast} + sv_i x i = x ∗ + s v i
ParetoExpand(x i x_i x i x i ∗ x_i^{\ast} x i ∗
Output:N N N
连续 Pareto 解(Pareto front)构建
通过前面求解出来 N N N K K K
给定 x i ∗ x_i^{\ast} x i ∗ K K K { x i ∗ 1 , ⋯ , x i ∗ k } \{ {x_i^{\ast}}_1,\cdots,{x_i^{\ast}}_k \} { x i ∗ 1 , ⋯ , x i ∗ k } r i → i j ∈ [ 0 , 1 ] r_{i \rightarrow {i}_j} \in [0,1] r i → i j ∈ [ 0 , 1 ] v i → i j = x i ∗ j − x i ∗ , j = 1 , 2 , ⋯ , K
v_{i \rightarrow {i}_j} = {x_i^{\ast}}_j - x_i^{\ast},j = 1,2,\cdots,K
v i → i j = x i ∗ j − x i ∗ , j = 1 , 2 , ⋯ , K x i ∗ x_i^{\ast} x i ∗ S ( x i ∗ ) = { x i ∗ + ∑ i = 1 K r i → i j u i → i j ∣ r i → i j ≥ 0 , ∑ i = 1 K r i → i j ≤ 1 }
S(x_i^{\ast}) = \{x_i^{\ast} + \sum_{i=1}^K r_{i \rightarrow {i}_j} u_{i \rightarrow {i}_j} | r_{i \rightarrow {i}_j} \geq 0,\sum_{i=1}^K r_{i \rightarrow {i}_j} \leq 1 \}
S ( x i ∗ ) = { x i ∗ + i = 1 ∑ K r i → i j u i → i j ∣ r i → i j ≥ 0 , i = 1 ∑ K r i → i j ≤ 1 } S ( x i ∗ ) S(x_i^{\ast}) S ( x i ∗ ) x i ∗ x_i^{\ast} x i ∗ K K K { x i ∗ 1 , ⋯ , x i ∗ K } \{ {x_i^{\ast}}_1,\cdots,{x_i^{\ast}}_K \} { x i ∗ 1 , ⋯ , x i ∗ K }
对于 N N N { S ( x 1 ∗ ) , ⋯ , S ( x N ∗ ) }
\{ S(x_1^{\ast}),\cdots,S(x_N^{\ast}) \}
{ S ( x 1 ∗ ) , ⋯ , S ( x N ∗ )}